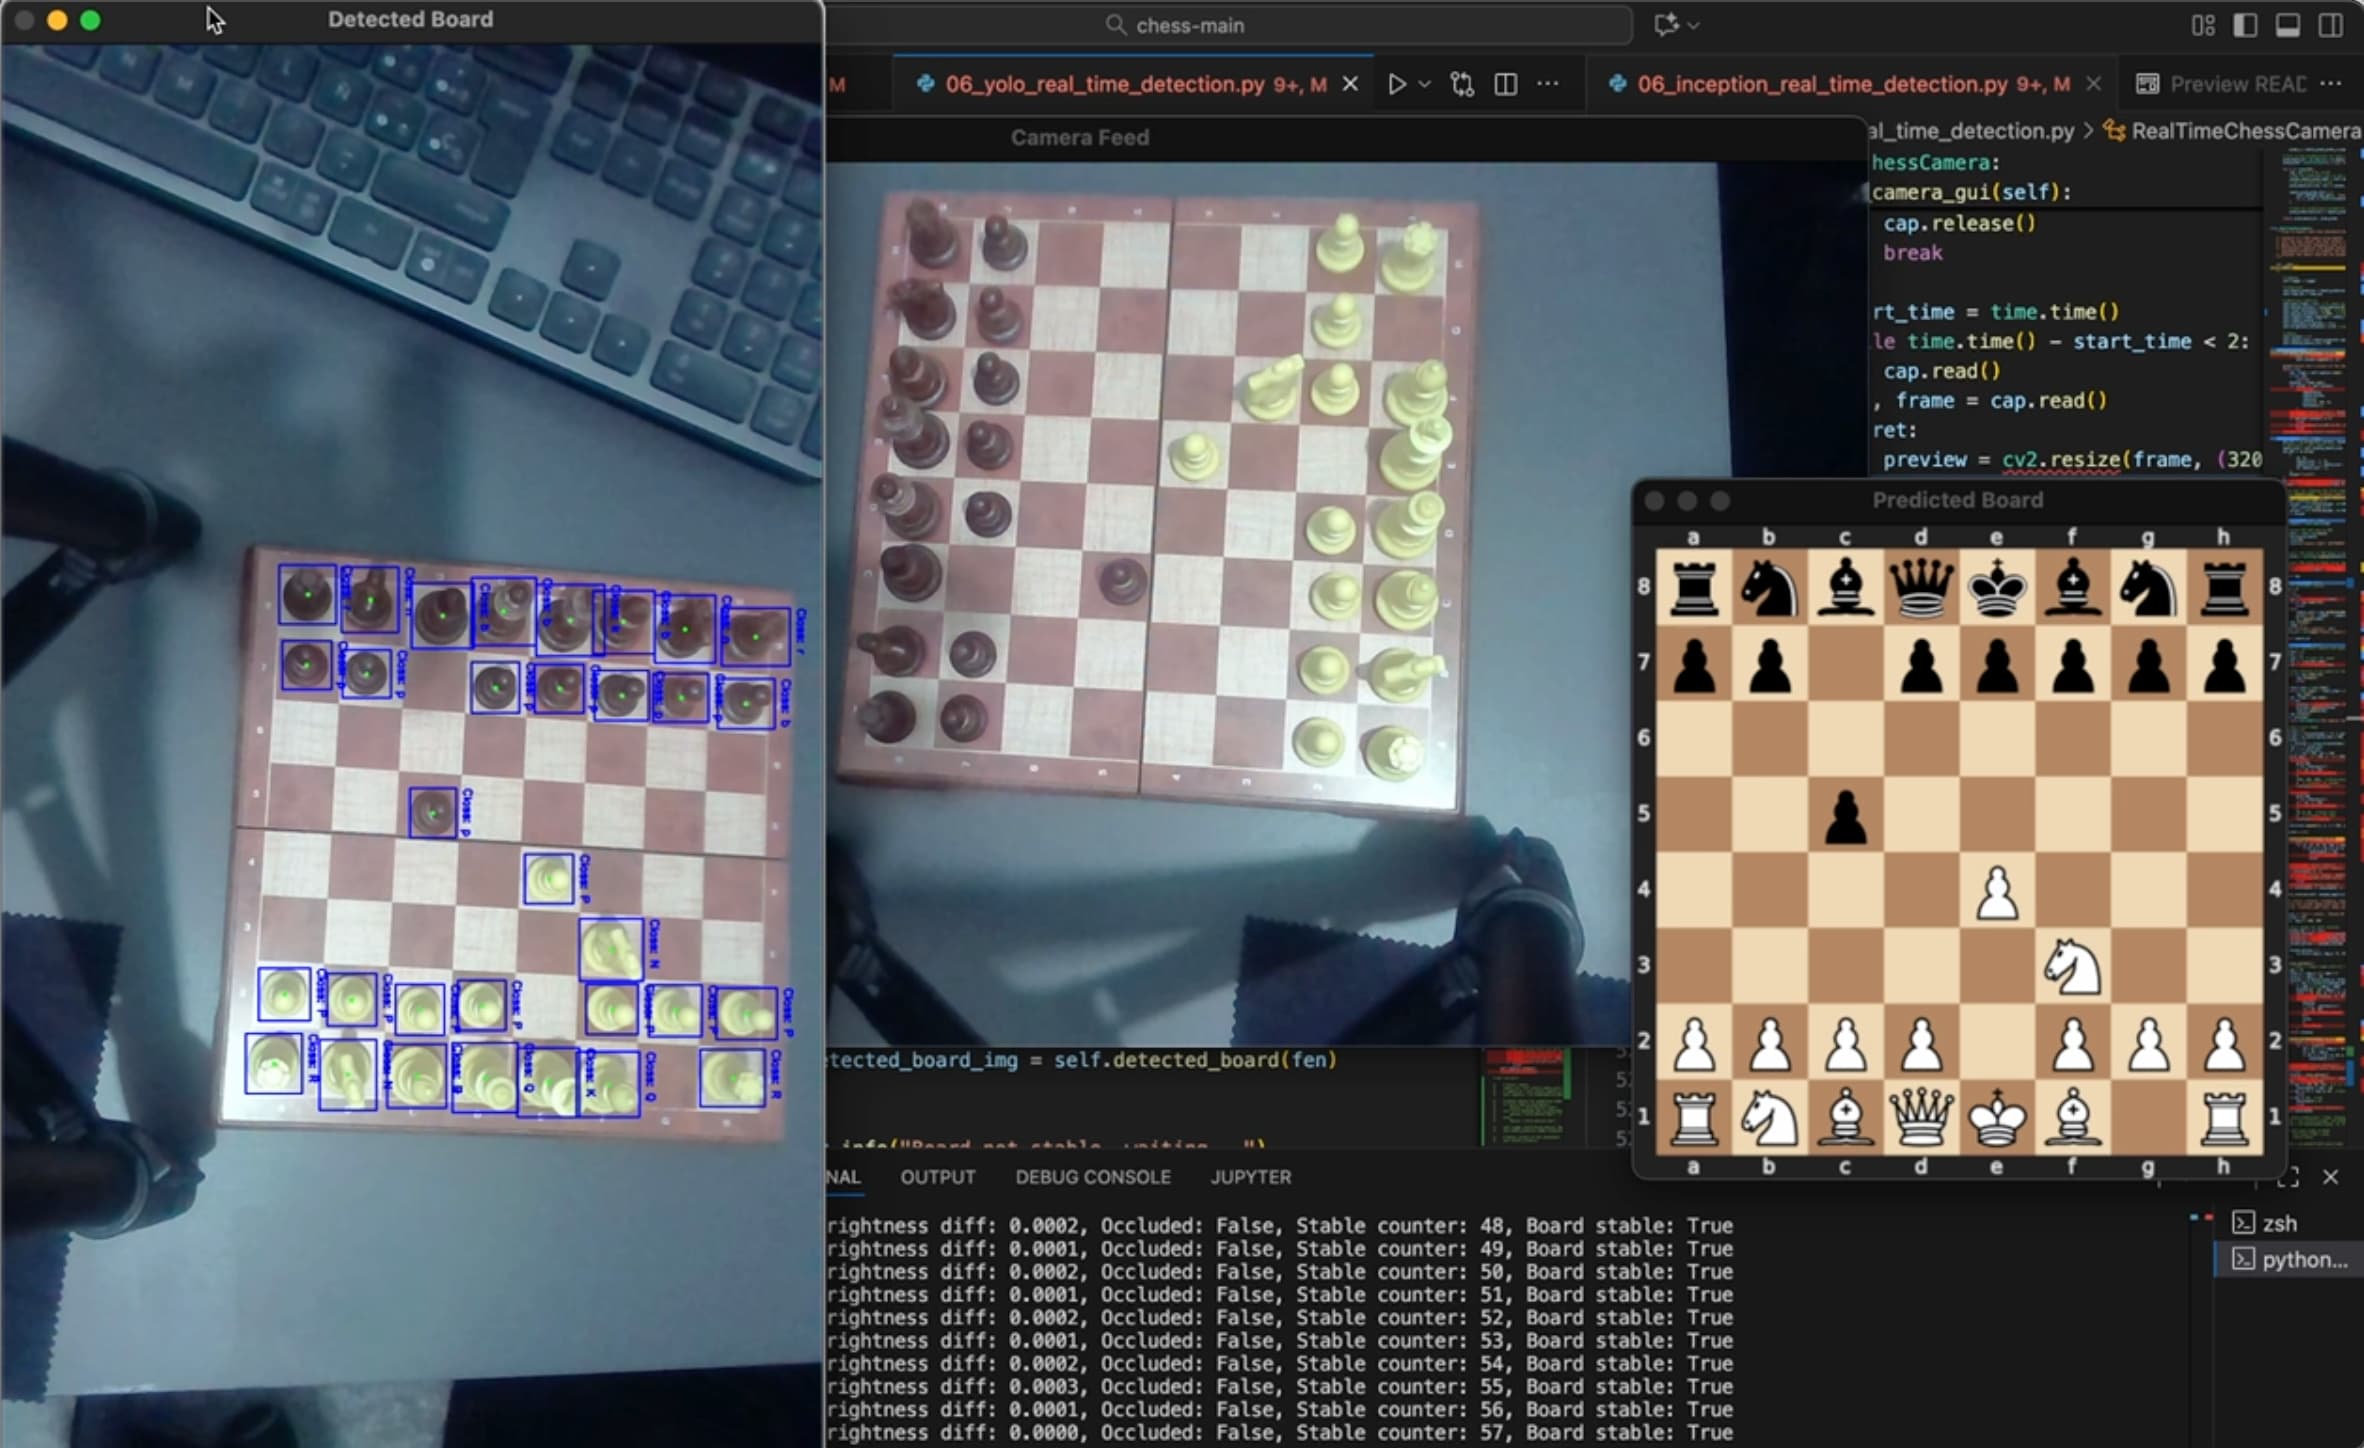
Visión por computador para la detección de jugadas de ajedrez en tiempo real
Este repositorio implementa un sistema de visión por computador para detectar jugadas de ajedrez en tiempo real a partir de un flujo de vídeo. Utiliza modelos de aprendizaje profundo, InceptionV3 y YOLOv8, para identificar las piezas de ajedrez y sus posiciones en el tablero, permitiendo una detección y un análisis precisos de las jugadas. El proyecto incluye componentes de recopilación de datos, entrenamiento y ajuste fino de modelos e inferencia en tiempo real. Como parte del proyecto, se incluye un marco para generar conjuntos de datos de imágenes/FEN utilizando vídeos de partidas de ajedrez disponibles públicamente en YouTube. Este marco se basa en un modelo CNN personalizado similar a AlexNet que extrae las jugadas de referencia de los tableros digitales de los vídeos y utiliza un algoritmo robusto de detección de jugadas basado en los logits predichos, las reglas del ajedrez y el historial de la partida.
Requisitos e instalación
Clona el repositorio:
git clone <repository-url>
cd cv-chess-detection
Para configurar el entorno, necesitas instalar los paquetes de Python necesarios. Puedes hacerlo mediante pip:
pip install -r requirements.txtAdemás, necesitas instalar pycairo, que es necesario para convertir las jugadas de ajedrez en imágenes. Puedes instalarlo mediante conda:
conda install -c conda-forge pycairoPara gestionar las métricas de los experimentos y guardar o cargar modelos entrenados, se utiliza MLflow. Una vez instalados los requisitos, puedes ejecutar la interfaz de MLflow mediante el siguiente comando:
mlflow ui --backend-store-uri file://$(pwd)/data/mlrunsEsto iniciará un servidor local en http://localhost:5000 donde puedes realizar un seguimiento de tus experimentos y modelos. También puedes utilizar el script disponible en el directorio raíz, que iniciará el servidor en el puerto 5002:
./run_mlflow.shGeneración de conjuntos de datos a partir de vídeos de YouTube
El objetivo del marco de generación de conjuntos de datos es utilizar vídeos de YouTube disponibles públicamente de partidas de ajedrez sobre tablero físico (OTB). Los vídeos suelen mostrar el tablero y las piezas desde un ángulo muy pronunciado y en condiciones de iluminación imperfectas, lo que dificulta la tarea de detectar las piezas y sus posiciones. También incluyen un tablero digital que muestra las jugadas realizadas en tiempo real, que se puede utilizar para extraer las jugadas y posiciones de referencia.
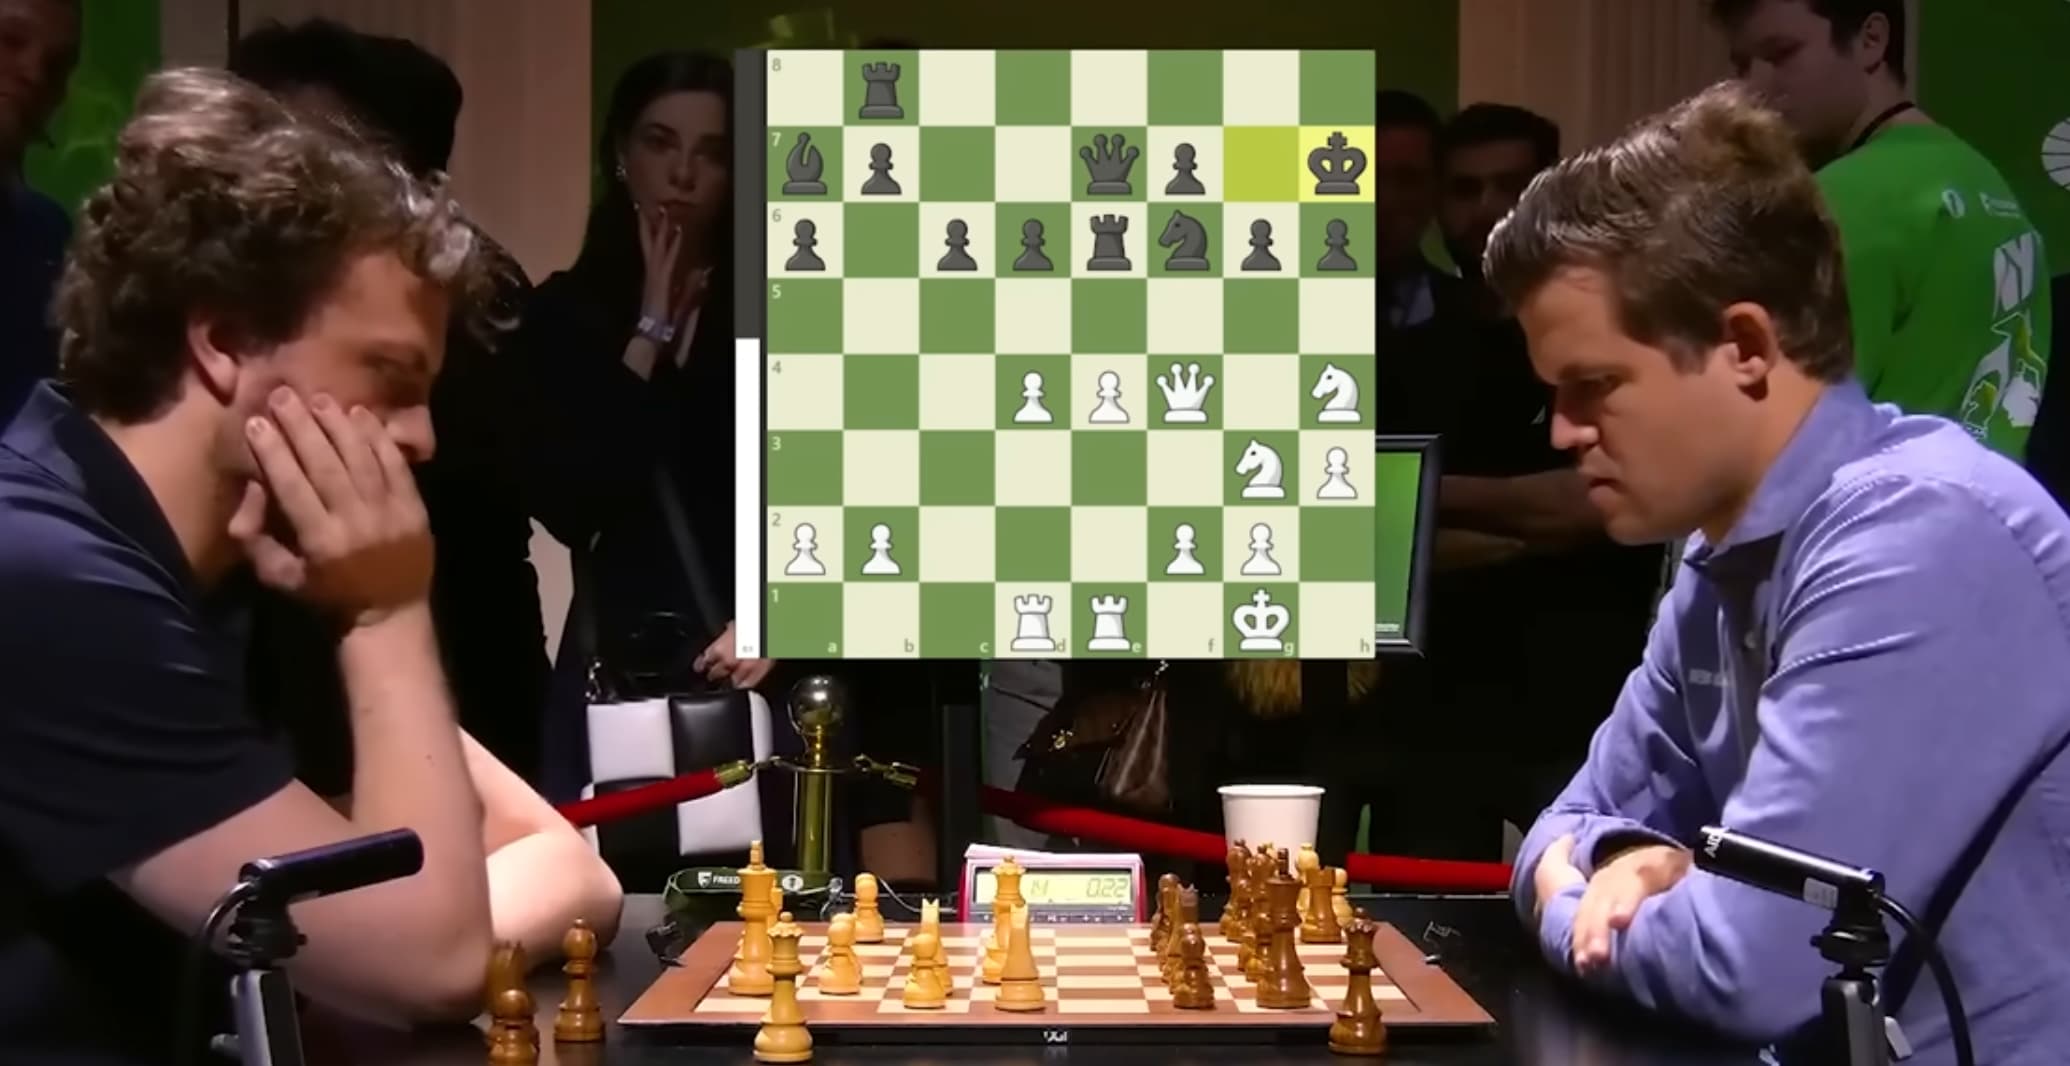
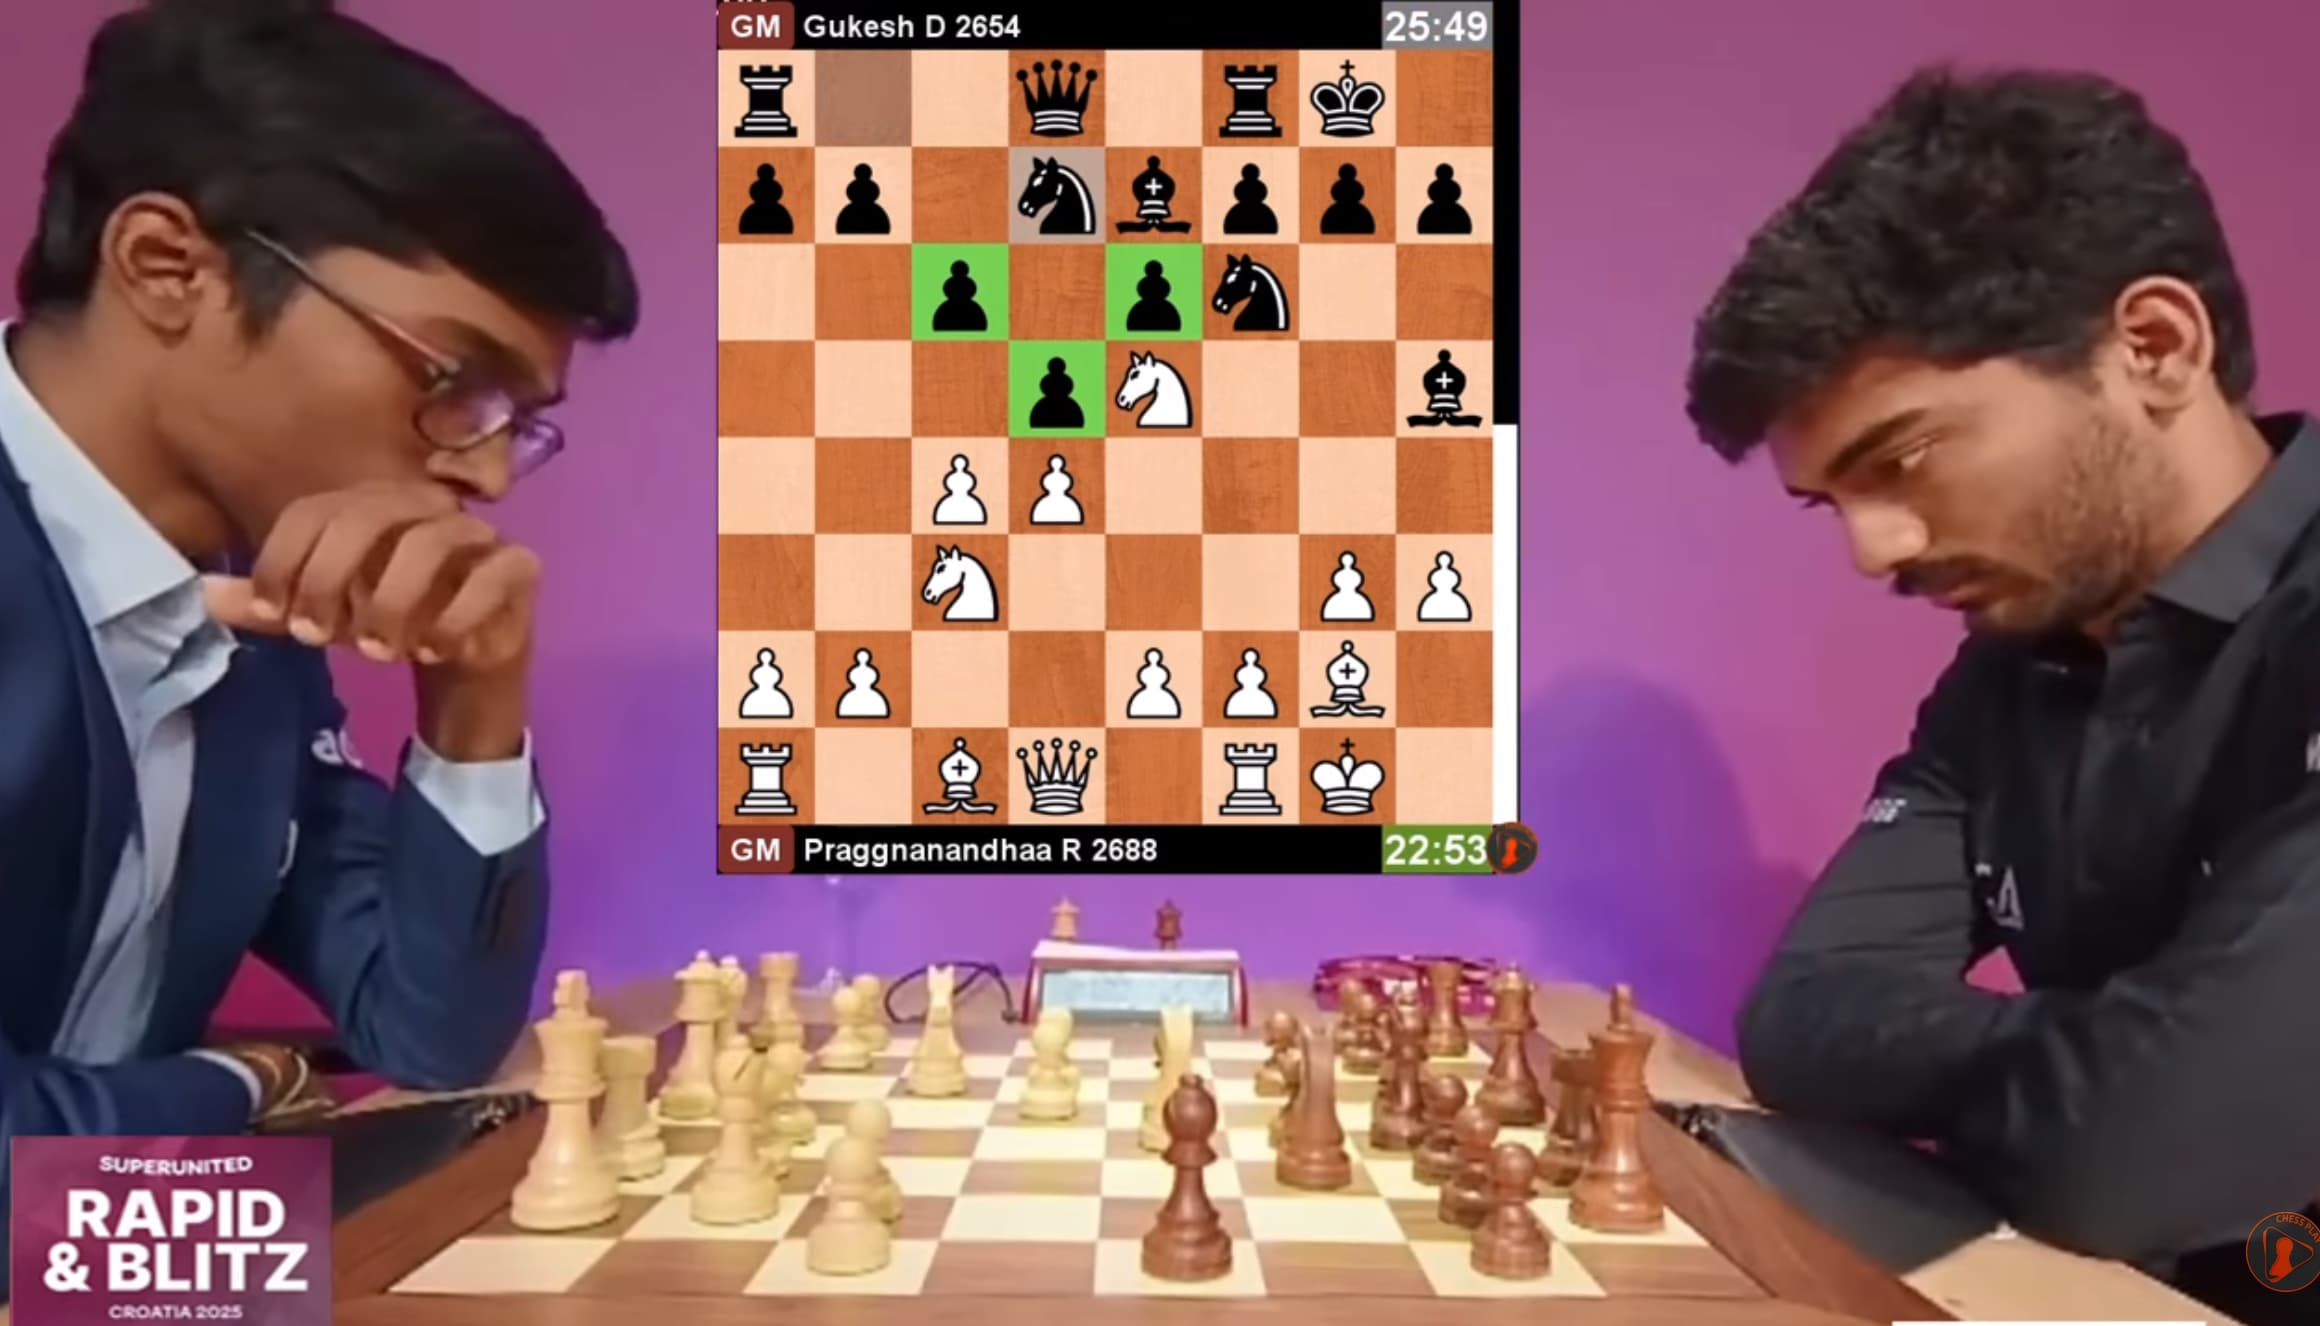
Actualmente, no existe un gran conjunto de datos de partidas de ajedrez sobre tablero físico disponible públicamente, por lo que este marco puede ser prometedor para abordar esta tarea y se podría utilizar para entrenar modelos más complejos y robustos para la detección de jugadas de ajedrez en tiempo real. La idea de este enfoque se basa en el repositorio [1], que intenta resolver el problema de generar un conjunto de datos de ajedrez a partir de vídeos de YouTube utilizando un modelo preentrenado de detección de tableros aplicado al tablero digital de los vídeos. Sin embargo, la falta de opciones en el proceso de extracción de vídeo reduce su aplicabilidad y la detección de jugadas basada en la existencia de suficientes detecciones de la misma jugada en el vídeo requiere procesar muchos fotogramas para obtener una buena exactitud.
Este proyecto proporciona un marco más flexible y modular para extraer las jugadas de ajedrez de los vídeos utilizando un modelo CNN entrenado específicamente para detectar las piezas del tablero digital e implementando un algoritmo de detección de jugadas más robusto basado en las reglas del ajedrez y el historial de la partida. Para ello, se utiliza la biblioteca python-chess para seleccionar las jugadas legales más probables y obtener la representación FEN de la posición de ajedrez.
La detección funciona extrayendo primero los fotogramas del vídeo en un segmento de tiempo determinado, dividiendo el tablero en 64 casillas y utilizando después una variante entrenada de AlexNet para predecir las piezas de cada casilla del tablero digital. La salida del modelo son los logits de cada clase (vacía, piezas blancas, piezas negras) para cada casilla. A partir de los logits se obtiene la clase predicha para cada casilla, así como la probabilidad de cada pieza o casilla vacía mediante una función softmax. Disponiendo de las probabilidades de todas las piezas en cada casilla, las jugadas se detectan calculando una pérdida para todos los tableros resultantes de aplicar cada jugada legal posible desde la posición actual y la pérdida de la posición actual suponiendo que no se ha realizado ninguna jugada. La pérdida se calcula a partir de las probabilidades de las piezas en las casillas y se selecciona como jugada detectada la de menor pérdida. Para evitar alucinaciones, también se realiza una comprobación hacia atrás, de modo que, si el error es demasiado alto, se puede deshacer la última jugada y elegir una de las jugadas legales de la posición anterior. Este marco de decisión también se utiliza en la detección de jugadas en tiempo real mediante modelos YOLOv8 o InceptionV3, como se explicará más adelante.
La principal limitación del marco implementado para la generación de conjuntos de datos es la intervención manual necesaria, como seleccionar los identificadores de los vídeos de YouTube, los segmentos de tiempo del inicio y el final de la partida y las esquinas del tablero en los fotogramas del vídeo. Como trabajo futuro, se pueden automatizar estos pasos, así como implementar un sistema de selección para evitar vídeos con flechas de comentarios, sugerencias de jugadas, etc., que no son válidos para generar el conjunto de datos. Para alcanzar el nivel de automatización deseado, se pueden utilizar algunas técnicas de visión por computador para detectar las esquinas del tablero en los fotogramas, así como algunas heurísticas para seleccionar los segmentos de tiempo de la partida en función de la duración del vídeo y la presencia de un tablero digital. Resolver estos pasos permitirá generar conjuntos de datos más grandes con una mayor variedad de partidas, tableros, piezas, condiciones de iluminación, ángulos, etc., que se podrán utilizar para entrenar modelos más robustos para la detección de jugadas en tiempo real.
Modelo de detección del tablero digital
El primer paso para entrenar el modelo de detección de piezas digitales que se utilizará en el marco de generación de conjuntos de datos es crear un conjunto de imágenes de tableros con los estilos de piezas y combinaciones de colores más comunes. Para ello, se proporciona un script para generar imágenes sintéticas de tableros con piezas mediante OpenCV y las bibliotecas python-chess y pycairo. El script src/01_render_chess_dataset.py crea un conjunto sintético de imágenes de tableros utilizando partidas jugadas en los torneos Titled Tuesday de Chess.com. El script utiliza la API pública de Chess.com para obtener las partidas, comprobar que sean partidas estándar (y no ajedrez Freestyle, que sigue reglas diferentes) y después generar imágenes del tablero en cada paso de la partida.
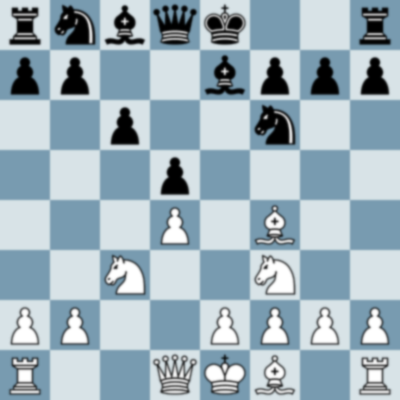
python src/01_render_chess_dataset.pyPara crear un modelo válido para los tableros y las piezas digitales más comunes, se utilizan distintas combinaciones de colores y estilos de piezas. Se pueden añadir más combinaciones de colores y estilos de piezas modificando las constantes BOARD_COLORS_LIST y CHESS_PIECES_PATHS del script. Las combinaciones de colores se basan en las más comunes disponibles en Chess.com y los estilos de piezas se basan en las piezas de Chess.com y de la biblioteca python-chess (piezas de Wikipedia). Las piezas disponibles en data/piece_images se han descargado de Chess.com y Wikipedia. Finalmente, las imágenes generadas se guardan en data/render_chess_dataset, que las divide en train, test y validation para poder cargarlas y utilizarlas para entrenar el modelo CNN. La variedad de tableros y piezas, así como el desenfoque añadido durante el procesamiento, hace que el conjunto de datos sea más robusto para entrenar un modelo que generalice bien a los tableros digitales de los vídeos de YouTube. Las siguientes imágenes muestran algunos ejemplos de los tableros generados sintéticamente:
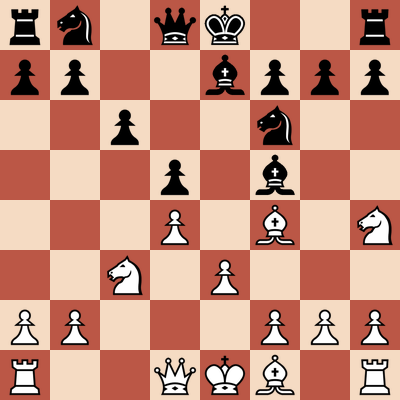
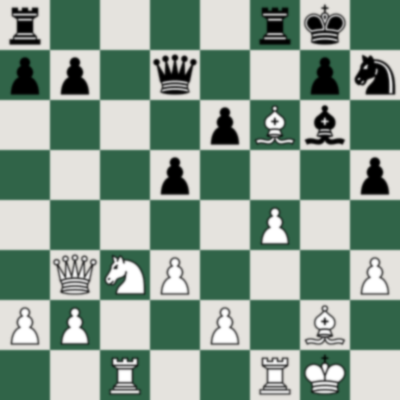
Una vez generado el conjunto de datos, se entrena un modelo CNN basado en AlexNet para clasificar las piezas de cada casilla del tablero. El modelo se implementa en src/02_train_chesspiece_model.py mediante PyTorch y se entrena para clasificar 13 clases (“0”, “R”, “N”, “B”, “Q”, “K”, “P”, “r”, “n”, “b”, “q”, “k”, “p”), que representan la casilla vacía, las piezas blancas (torre, caballo, alfil, dama, rey, peón) y las piezas negras (torre, caballo, alfil, dama, rey, peón). El modelo se entrena durante 5 épocas con un tamaño de lote de 64 y una tasa de aprendizaje de 0.001, utilizando una pérdida de entropía cruzada y el optimizador Adam. El proceso de entrenamiento incluye técnicas de aumento de datos para mejorar la robustez del modelo. El proceso utiliza MLflow para realizar un seguimiento de los experimentos y guardar el mejor modelo en función de la exactitud de validación. Tras el entrenamiento, el modelo se guarda en el directorio data/models.
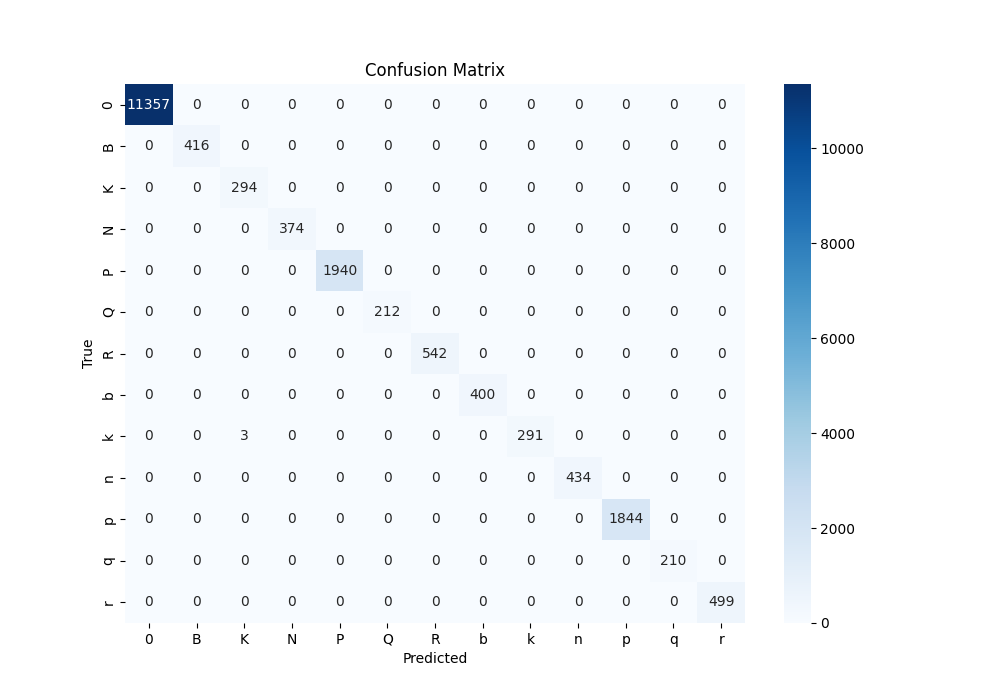
python src/02_train_render_classification_model.pyLas métricas de entrenamiento se pueden visualizar ejecutando run_mlflow.sh, que busca el directorio data/mlruns e inicia la interfaz de MLflow en el puerto 5002. Después puedes acceder a la pestaña Experiments y seleccionar el experimento llamado RenderChessModel para ver los resultados del entrenamiento. Para analizar los resultados, también puedes ejecutar la función de prueba del script src/02_train_render_classification_model.py, que carga el mejor modelo de MLflow y el run_id seleccionado y lo evalúa sobre el conjunto de prueba. La función de prueba calcula la exactitud, la precisión, la exhaustividad, la puntuación F1 y la matriz de confusión del conjunto de prueba e imprime los resultados. La matriz de confusión también se representa mediante la biblioteca seaborn para visualizar el rendimiento del modelo en cada clase. Como se ve en la siguiente matriz de confusión, el modelo funciona perfectamente para todas las clases y no hay confusión entre las piezas, salvo 3 clasificaciones erróneas entre k y K. Las métricas de evaluación también muestran valores casi perfectos de exactitud=0.9998, precisión=0.9998, exhaustividad=0.9998 y puntuación F1=0.9998. En general, el modelo funciona bien y, a pesar del posible cambio de distribución entre el conjunto sintético y los tableros digitales reales de los vídeos de YouTube, predice las piezas con una exactitud elevada y el algoritmo de detección de jugadas puede gestionar los pequeños errores.
Generación del conjunto de datos
Una vez entrenado el modelo de detección de piezas digitales, se puede utilizar para generar un conjunto de datos de partidas de ajedrez reales a partir de vídeos de YouTube. El script src/03_real_chess_dataset.py implementa el marco de generación descrito anteriormente. El script recibe como entrada una lista de identificadores de vídeos de YouTube y segmentos de tiempo para el inicio y el final de la partida, así como las esquinas del tablero real y del tablero digital en los fotogramas. Estos ajustes se pueden modificar en el archivo src/video_settings.py, donde se define un diccionario con los identificadores y ajustes de todos los vídeos que se van a procesar. Para facilitar la selección de las esquinas del tablero, se proporciona un cuaderno auxiliar src/03_find_corners.ipynb que permite seleccionar las esquinas del tablero en un fotograma determinado mediante ipywidgets. A continuación se muestra un ejemplo de los ajustes para 2 vídeos, donde video_id es el identificador del vídeo de YouTube, gt_board_loc son las esquinas del tablero digital de referencia, irl_board_loc son las esquinas del tablero real en el fotograma, time_range es el segmento de tiempo del inicio y el final de la partida con el formato ["MM:SS:CC", "MM:SS:CC"] y step_sec es el intervalo en segundos para extraer fotogramas del vídeo. Además, se puede proporcionar un initial_state opcional para establecer la posición inicial del tablero. Si no se proporciona, se asume la posición inicial estándar del ajedrez.
    1: {
        "video_id": "rrPfmSWlAPM",
        "gt_board_loc": [88, 558, 764, 1233],
        "irl_board_loc": [606, 911, 582, 1356],
        "time_range": ["0:02:30", "6:52:00"],
        "step_sec": 1,
    },
    9: {
        "video_id": "Jvv0Dom8vkc",
        "gt_board_loc": [62, 580, 726, 1243],
        "irl_board_loc": [615, 1080, 582, 1339],
        "time_range": ["0:00:00", "8:44:00"],
        "step_sec": 0.25,
        "initial_state": [
            ["r", "n", "b", "q", "k", "b", "n", "r"],
            ["p", "p", "0", "p", "p", "p", "p", "p"],
            ["0", "0", "0", "0", "0", "0", "0", "0"],
            ["0", "0", "p", "0", "0", "0", "0", "0"],
            ["0", "0", "0", "0", "0", "0", "0", "0"],
            ["0", "0", "0", "0", "0", "0", "P", "0"],
            ["P", "P", "P", "P", "P", "P", "0", "P"],
            ["R", "N", "B", "Q", "K", "B", "N", "R"],
        ],
    },
Para cada vídeo, la clase VideoBoardExtractor se encarga de extraer los fotogramas cada step_sec segundos en el segmento de tiempo indicado, recortar el tablero digital y el tablero real utilizando las esquinas proporcionadas, llamar al método predict de la clase GTChessboardPredicotor para predecir la jugada, guardar las imágenes correspondientes en las carpetas gt, ìrl y pred y actualizar el archivo fen.csv con la representación FEN de todas las posiciones. Por otro lado, la clase GTChessboardPredictor se encarga de predecir las jugadas a partir de las imágenes recortadas del tablero digital. Cada vez que se llama al método predict, este llama a su vez al método predict_gt_board, que recorta la imagen del tablero en 64 casillas y las introduce como un lote en el modelo entrenado de detección de piezas. Los logits resultantes se utilizan después para calcular las probabilidades de cada pieza en cada casilla mediante una función softmax. La posición predicha del tablero y todas las probabilidades se devuelven al método predict, que utiliza el algoritmo robusto de detección de jugadas para detectar la jugada realizada más probable en función de la posición actual, las probabilidades de cada pieza en cada casilla y el historial de la partida. Esta lógica se implementa en el método get_valid_move_and_board, que decide la jugada realizada más probable en función de las pérdidas de todas las posiciones posibles resultantes de aplicar cada jugada legal desde la posición actual. La función de pérdida se calcula a partir de las probabilidades de las piezas en las casillas para la posición de ajedrez en cuestión. La expresión concreta de la función de pérdida se define en get_board_loss y es la siguiente:
donde es la probabilidad de la pieza en la casilla de la posición de ajedrez evaluada. También se evalúa la posición actual suponiendo que no se ha realizado ninguna jugada y, si su pérdida es menor que la de la jugada mejor valorada, se asume que no se ha realizado ninguna jugada y se mantiene la posición actual. Además, si la pérdida de la jugada mejor valorada supera un umbral, se realiza una comprobación hacia atrás para deshacer la última jugada y elegir una de las jugadas legales de la posición anterior. La jugada detectada y la pérdida mínima se devuelven después junto con la nueva posición a la clase VideoBoardExtractor, que renderiza la posición predicha, guarda las imágenes y actualiza el archivo fen.csv, junto con un archivo min_losses.csv que contiene las pérdidas de la jugada mejor valorada.
python src/03_real_chess_dataset.pyTras ejecutar el script, el conjunto de datos generado se guardará en data/real_chess_dataset, que contiene una carpeta por vídeo con la siguiente estructura:
real_chess_dataset/
    video_id_1/
        gt/               # Cropped images of the digital chessboard
        irl/              # Cropped images of the real chessboard
        pred/             # Rendered images of the predicted chess position
        fen.csv          # CSV file with the FEN representation of all positions
    video_id_2/
    ...
El último paso es comprobar la calidad del conjunto de datos generado visualizando los FEN predichos y las imágenes correspondientes. Para esta tarea, se puede generar un vídeo combinando las imágenes de las carpetas gt, irl y pred. Una forma sencilla de validar las jugadas predichas de un vídeo es comparar la última posición de gt con la última posición de pred y comprobar si son iguales. Si no lo son, hay un error en la detección de jugadas. Una fuente habitual de errores es un time_step grande, que puede hacer que se omitan algunas jugadas. Para encontrar el paso en el que se produce el error, se puede analizar el archivo min_losses.csv para localizar el paso en el que la pérdida comienza a aumentar significativamente. Esto puede indicar que el modelo no tiene confianza en la jugada predicha y que probablemente se ha producido un error.
Detección de jugadas de ajedrez en tiempo real
El objetivo principal de este proyecto es implementar un sistema de detección de jugadas de ajedrez en tiempo real mediante modelos de aprendizaje profundo. La idea es utilizar una cámara para capturar el flujo de vídeo de una partida y después procesar los fotogramas en tiempo real para detectar las jugadas realizadas. Aquí se utiliza el mismo algoritmo de detección de jugadas del marco de generación de conjuntos de datos para detectar las jugadas a partir de las piezas predichas en cada casilla del tablero. Aunque el algoritmo calcula la pérdida de todas las jugadas legales posibles desde la posición actual, el rendimiento en tiempo real se consigue utilizando modelos de aprendizaje profundo eficientes para predecir las piezas de cada casilla, ya que el algoritmo de detección de jugadas se calcula muy rápidamente.
Sin embargo, la detección de jugadas en tiempo real añade otros retos respecto al marco de generación de conjuntos de datos, como detectar cuándo se realiza una jugada o gestionar oclusiones como la mano del jugador. Este problema se aborda detectando cuándo la imagen está estable a partir de la diferencia de imagen entre el fotograma actual y los anteriores y la diferencia de color medio. Esto se explicará con más detalle en los siguientes apartados.
Para entrenar o ajustar los modelos de detección de jugadas en tiempo real, una posibilidad es utilizar el conjunto de datos generado de partidas reales a partir de vídeos de YouTube. Sin embargo, como los vídeos se graban desde un ángulo pronunciado y los tableros no están perfectamente alineados, puede resultar difícil incluso para una persona identificar las piezas de cada casilla. Por tanto, se requiere un modelo más complejo y un conjunto de datos ampliado para lograr un buen rendimiento, siendo este un problema actual del estado del arte en visión por computador. Por esta razón, y como prueba de concepto, se utiliza un conjunto de imágenes de ajedrez en vista cenital para entrenar y ajustar los modelos. Aunque las imágenes cenitales presentan menos dificultades que las imágenes desde ángulos pronunciados, un modelo pequeño como AlexNet no es capaz de lograr un buen rendimiento con este conjunto de datos. Por ello, se implementan dos enfoques diferentes utilizando modelos más complejos como InceptionV3 y YOLOv8. La aplicación del aprendizaje por transferencia permite lograr un buen rendimiento con un conjunto de datos relativamente pequeño de unas 200 imágenes.
Preparación del conjunto de datos en vista cenital
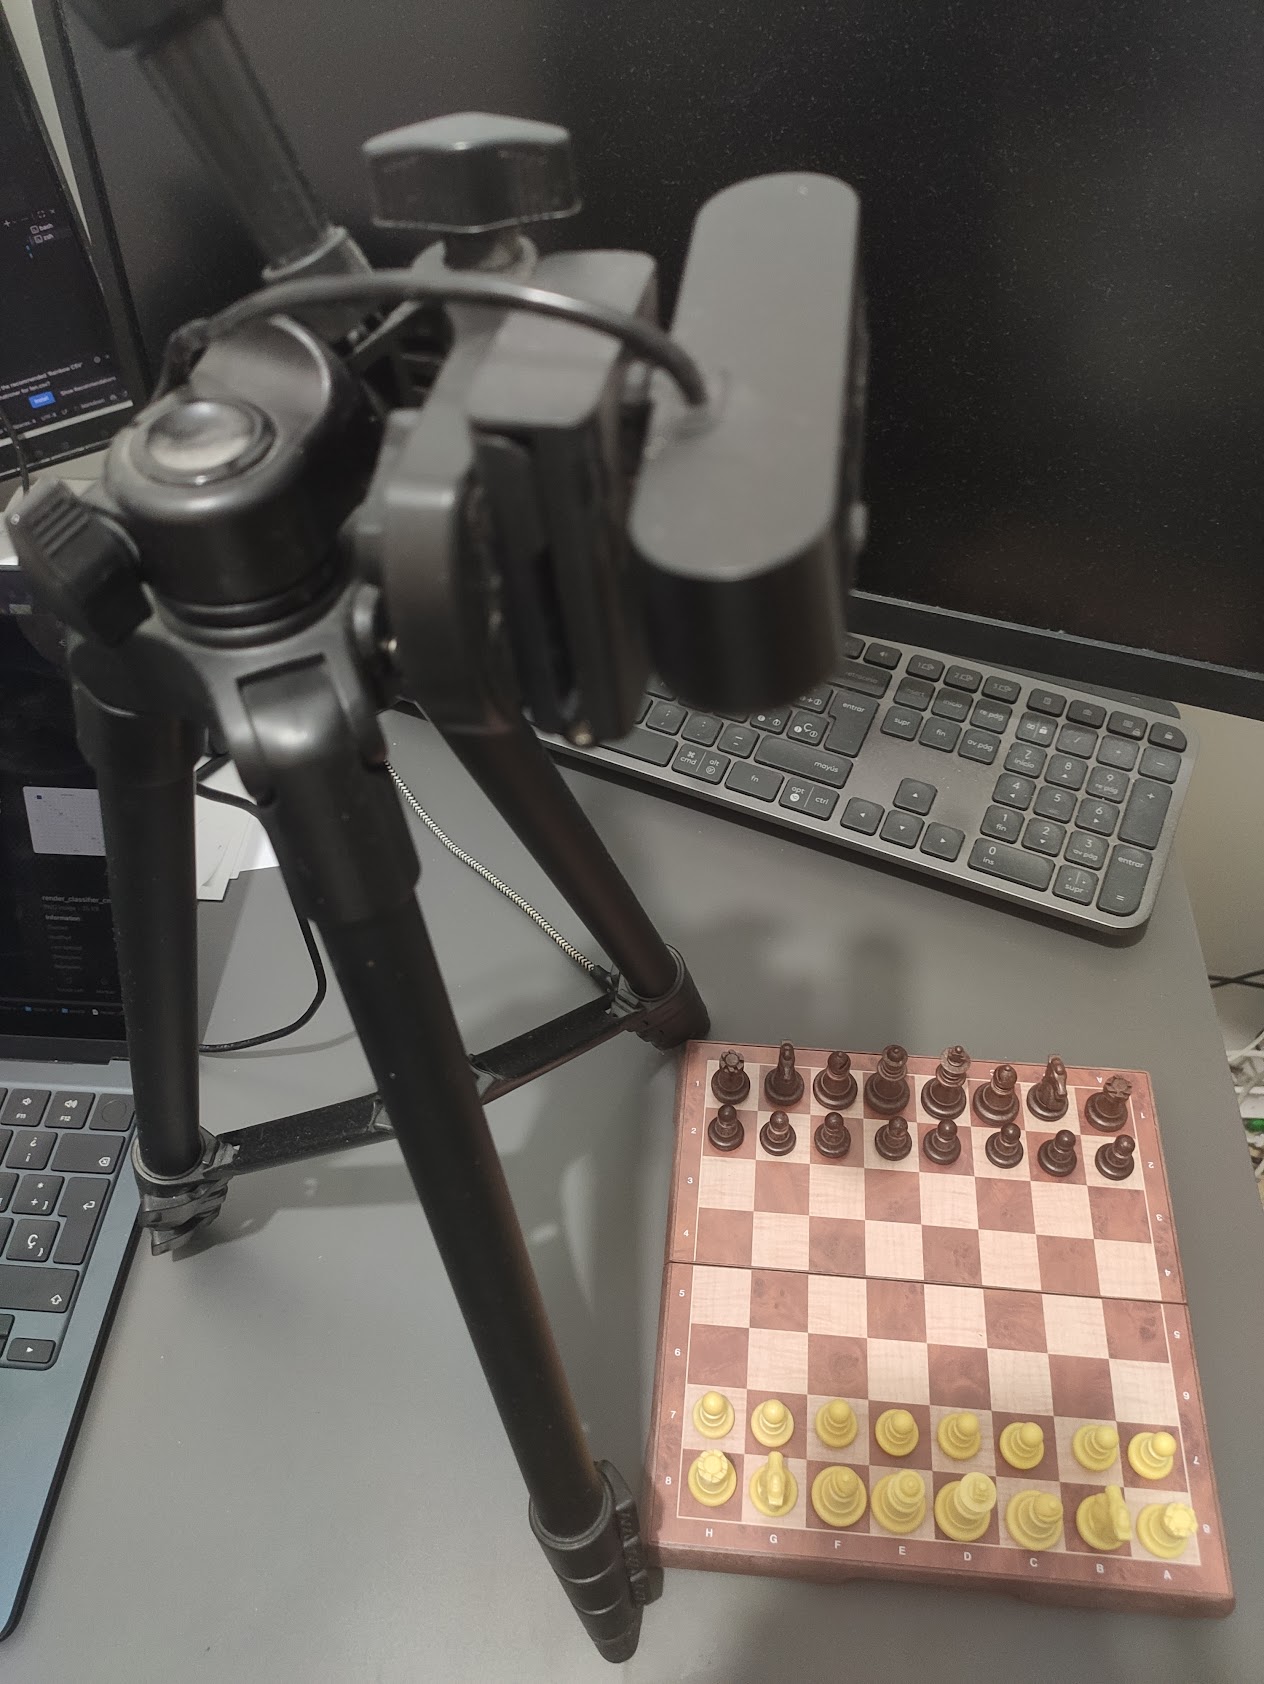
Se crea un pequeño conjunto de imágenes de ajedrez en vista cenital utilizando la misma cámara que se utilizará para la detección de jugadas en tiempo real. El proceso de creación del conjunto consiste en grabar dos vídeos que reproducen dos partidas distintas. Las partidas replican las jugadas de dos partidas de los vídeos de YouTube extraídos, pero pueden ser cualquier partida. Los vídeos se graban con una resolución de 720p y una tasa de 30 fotogramas por segundo. La cámara se coloca sobre el minitablero para capturar una imagen cenital de las piezas, pero no está perfectamente alineada y presenta un pequeño ángulo debido a la configuración del montaje. La calidad de la cámara y las condiciones de iluminación no son óptimas, lo que dificulta un poco más la tarea. Las siguientes imágenes muestran el montaje y un ejemplo de imagen del conjunto de datos grabado. El montaje utilizado para grabar los vídeos emplea una cámara web económica de 720p para capturar el flujo de vídeo, atornillada al soporte para colocarla sobre el tablero. Como se puede ver en la imagen, la cámara no está perfectamente alineada con el tablero y hay algunas sombras debido a las condiciones de iluminación.
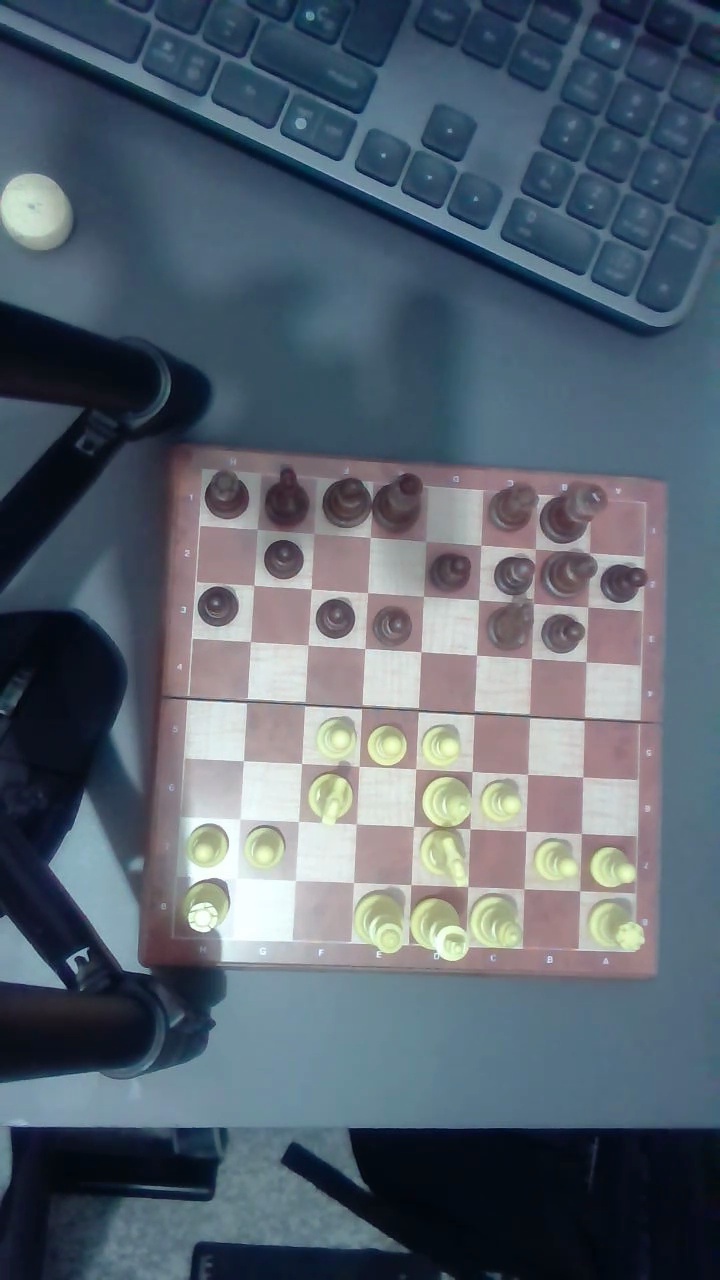
El proceso de creación del conjunto de datos consistió en grabar un vídeo y después extraer las imágenes de cada jugada realizada mediante una serie de marcas de tiempo. Este proceso se realiza manualmente y se puede consultar en el cuaderno ssrc/03_dataset_from_video.ipynb, donde se enumeran las marcas de tiempo de cada jugada y el código utiliza OpenCV para extraer los fotogramas del vídeo y guardarlos en el directorio data/recorded_dataset. Las imágenes se guardan dentro de la subcarpeta irl y el archivo fen.csv contiene la representación FEN de todas las posiciones con el siguiente formato, que es el mismo utilizado en el marco de generación de conjuntos de datos:
,index,frame,fen
0,0,0,rnbqkbnr/pppppppp/8/8/8/8/PPPPPPPP/RNBQKBNR
1,1,2,rnbqkbnr/pppppppp/8/8/4P3/8/PPPP1PPP/RNBQKBNR
2,2,7,rnbqkbnr/pp1ppppp/8/2p5/4P3/8/PPPP1PPP/RNBQKBNR
3,3,11,rnbqkbnr/pp1ppppp/8/2p5/4P3/2N5/PPPP1PPP/R1BQKBNR
...
Detección de jugadas de ajedrez en tiempo real mediante InceptionV3
El primer enfoque para la detección de jugadas de ajedrez en tiempo real utiliza el modelo InceptionV3 para predecir las piezas de cada casilla del tablero. El modelo se implementa en src/05a_finetune_inception_detector.py mediante PyTorch y se entrena para clasificar las mismas 13 clases que la CNN AlexNet más sencilla utilizada para los tableros digitales. El modelo se ajusta a partir de un InceptionV3 preentrenado en ImageNet-1K, proporcionado por la biblioteca torchvision y basado en el artículo [4]. El aprendizaje por transferencia permite lograr un buen rendimiento con un conjunto de datos relativamente pequeño de unas 200 imágenes, congelando los pesos de las capas convolucionales y entrenando únicamente las capas completamente conectadas adaptadas a las 13 clases.
cd src
python 05a_finetune_inception_detector.py
Antes de comenzar el entrenamiento, es necesario preparar el conjunto de datos para la tarea de entrenamiento. El script src/04_square_imgs_dataset.py implementa una aplicación sencilla de Gradio para seleccionar manualmente las 4 esquinas del tablero en una imagen y después transformar todas las imágenes del conjunto para obtener una imagen cuadrada del tablero en vista cenital, que será la entrada del modelo. A continuación se muestra un ejemplo de la aplicación de Gradio, donde se seleccionan las esquinas del tablero y después se transforman todas las imágenes y se guardan en el directorio squared dentro del directorio data/recorded_dataset.
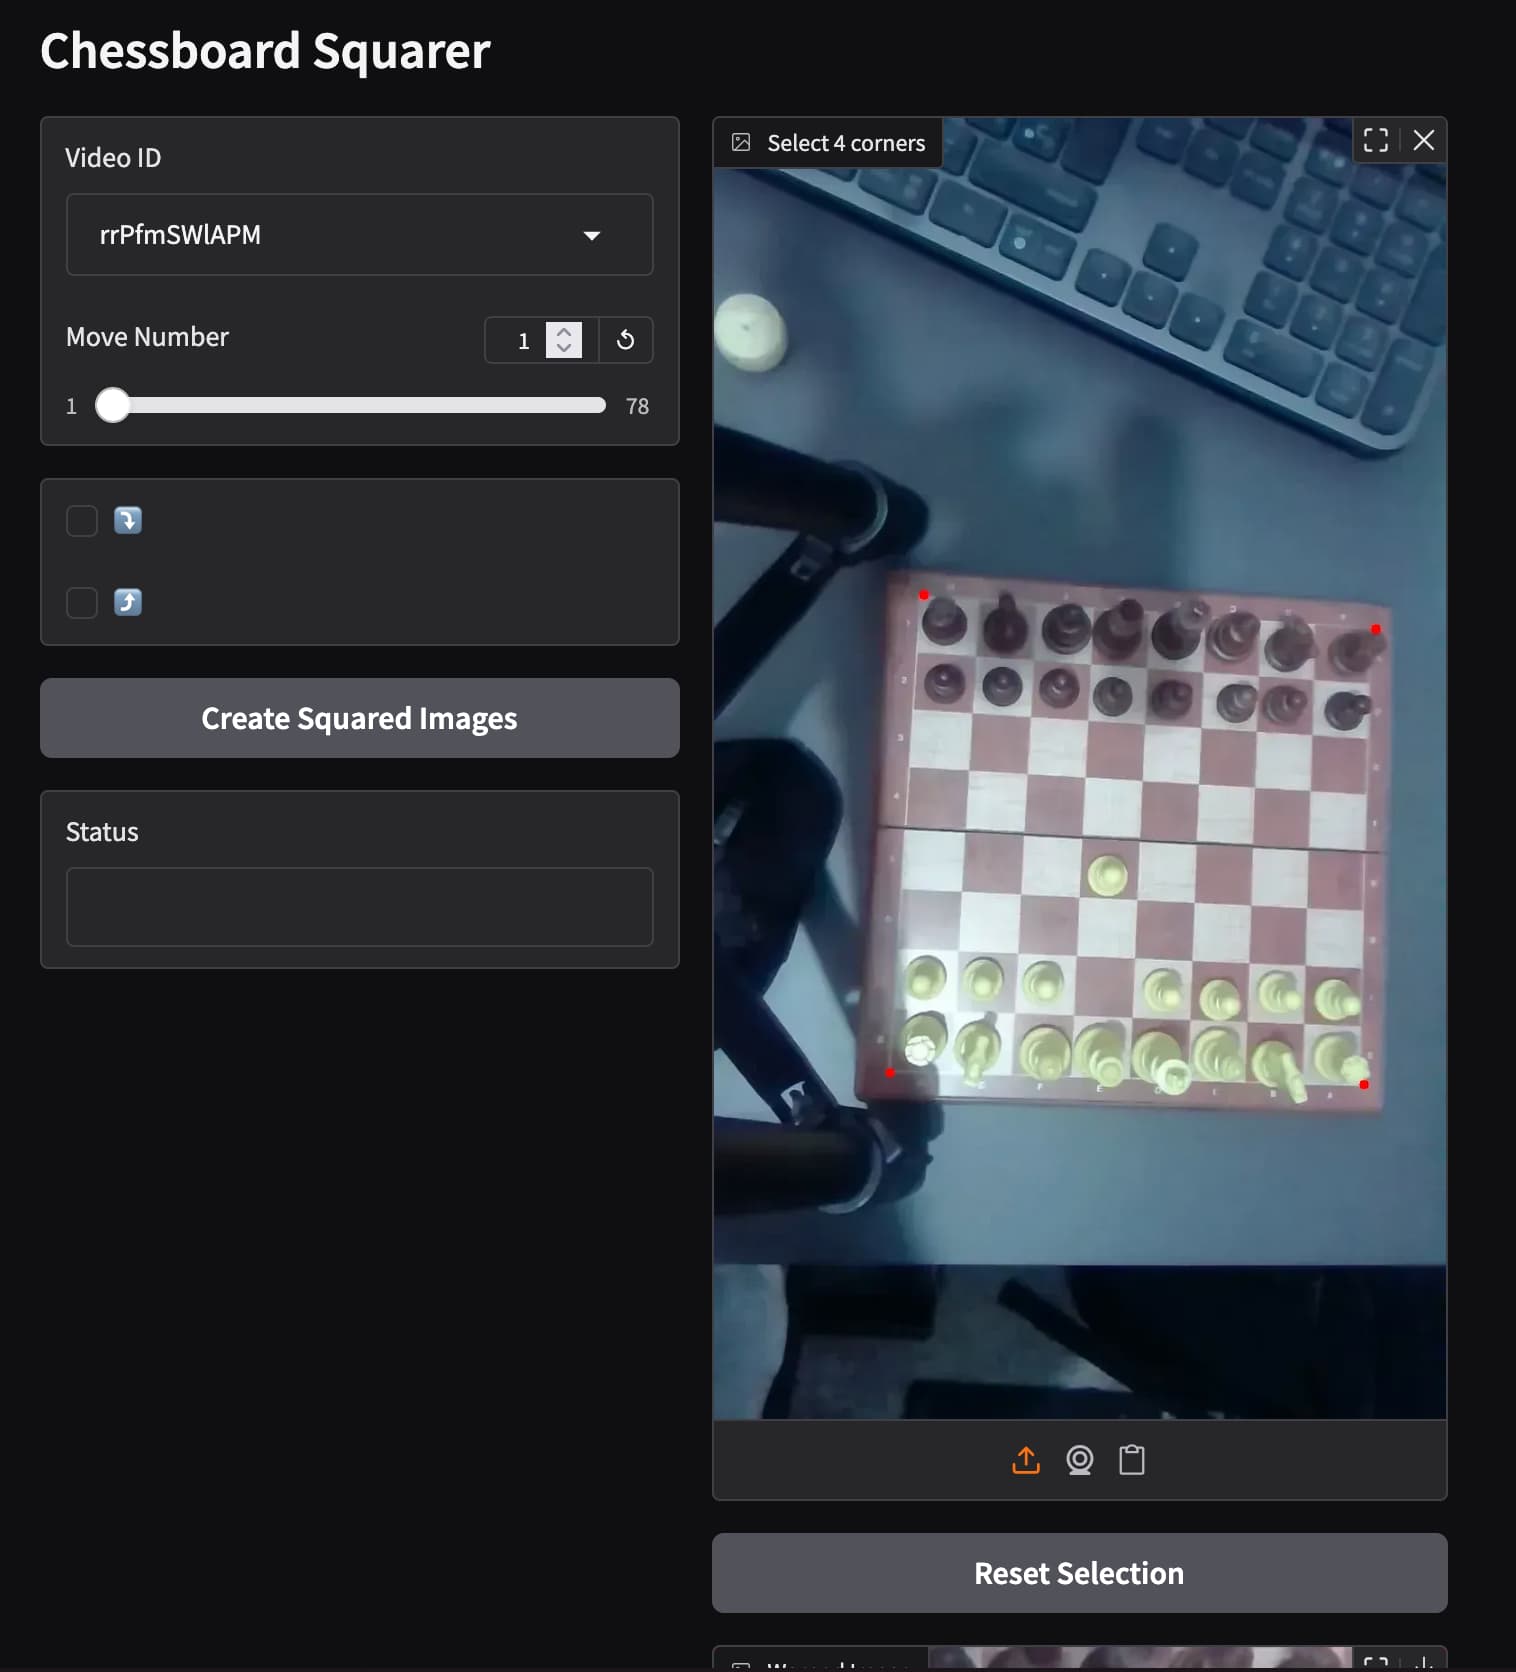
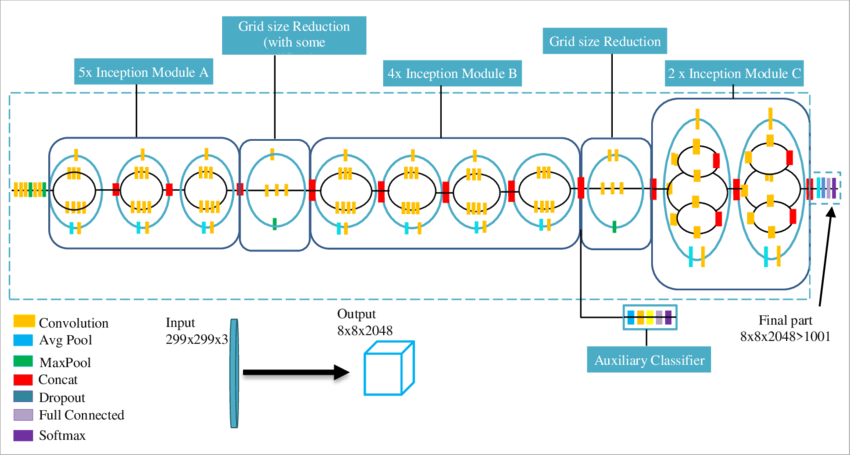
Una vez preparado el conjunto de datos, se realiza el ajuste fino del modelo durante 3 épocas con un tamaño de lote de 128 y una tasa de aprendizaje de 0.001, utilizando pérdida de entropía cruzada y el optimizador Adam. Como el modelo espera un tamaño de entrada de 299x299, las imágenes recortadas de cada casilla se redimensionan a ese tamaño antes de introducirlas en el modelo. El proceso de entrenamiento incluye técnicas de aumento de datos para mejorar la robustez del modelo. Entre ellas se incluyen rotaciones aleatorias, volteos horizontales y verticales, variaciones de color y recortes aleatorios, que multiplican por 4 el tamaño del conjunto de datos. La siguiente imagen muestra la arquitectura del modelo InceptionV3 utilizado para el ajuste fino, donde se congelan todas las capas hasta “Mixed_7c”. “Mixed_7c” es uno de los últimos bloques inception, situado justo antes de las capas de agrupación por promedio y completamente conectadas, y tiene dimensiones de características de 8x8.
Como antes, el proceso de entrenamiento utiliza MLflow para realizar un seguimiento de los experimentos y guardar el mejor modelo en función de la exactitud de validación. Tras el entrenamiento, los modelos y las métricas se guardan en el directorio data/mlruns y se pueden visualizar mediante la interfaz de MLflow. El script también proporciona una función de prueba para evaluar el mejor modelo sobre el conjunto de prueba e imprimir la exactitud, la precisión, la exhaustividad, la puntuación F1 y la matriz de confusión. La siguiente tabla muestra las métricas de evaluación de todas las clases y la exactitud global, la media macro y la media ponderada, que reflejan un buen rendimiento en general (F1 = 0.93), a pesar de una exhaustividad baja para algunas clases como K, N y k.
| Etiqueta | Precisión | Exhaustividad | Puntuación F1 | Número de muestras |
|---|---|---|---|---|
| R | 1.00 | 1.00 | 1.00 | 5050 |
| N | 1.00 | 0.46 | 0.63 | 194 |
| B | 0.65 | 0.98 | 0.78 | 174 |
| Q | 0.76 | 0.97 | 0.85 | 222 |
| K | 1.00 | 0.29 | 0.45 | 115 |
| P | 0.63 | 0.85 | 0.72 | 118 |
| 0 | 0.96 | 0.98 | 0.97 | 935 |
| r | 0.74 | 0.65 | 0.69 | 229 |
| n | 0.57 | 0.93 | 0.70 | 148 |
| b | 0.63 | 0.91 | 0.75 | 164 |
| q | 0.83 | 0.56 | 0.67 | 106 |
| k | 0.91 | 0.30 | 0.45 | 145 |
| p | 0.96 | 0.95 | 0.95 | 899 |
| Exactitud | 0.93 | 8499 | ||
| Media macro | 0.82 | 0.76 | 0.74 | 8499 |
| Media ponderada | 0.95 | 0.93 | 0.93 | 8499 |
A continuación se muestra la matriz de confusión del mejor modelo y del conjunto de prueba, donde el modelo funciona bien en la mayoría de los casos, pero algunas clases se confunden con otras, como algunos caballos con alfiles o reyes con alfiles en ciertos casos. El algoritmo de detección de jugadas puede gestionar estas pequeñas clasificaciones erróneas.
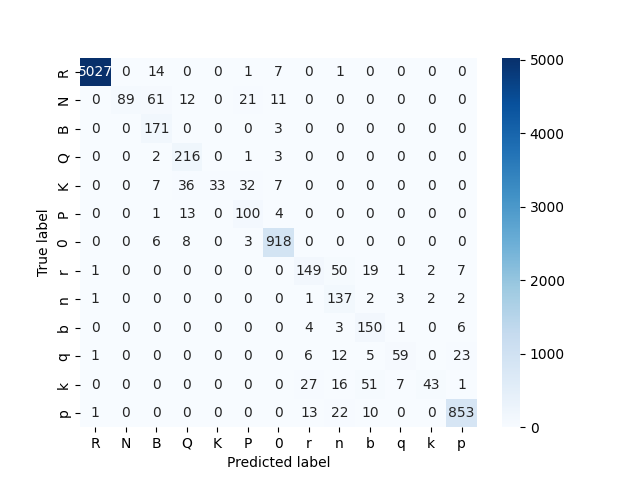
El último paso tras entrenar el modelo es implementar la detección de jugadas en tiempo real utilizando el modelo entrenado. El script src/06_inception_real_time_detection.py implementa la detección de jugadas en tiempo real utilizando OpenCV para capturar el flujo de vídeo de la cámara y procesar los fotogramas en tiempo real para predecir la jugada mediante el modelo entrenado. Incluye una clase RealTimeChessCamera encargada de gestionar el flujo de la cámara y procesar los fotogramas, detectar oclusiones o movimiento para evitar llamar al modelo cuando un jugador está realizando una jugada y llamar al método predict de la clase RTChessboardPredictor para predecir las jugadas.
Como en el caso del marco de generación de conjuntos de datos, la clase RTChessboardPredictor se encarga de predecir las jugadas recortando la imagen del tablero en 64 casillas, introduciéndolas como un lote en el modelo InceptionV3 entrenado, calculando las probabilidades de cada pieza en cada casilla mediante una función softmax y utilizando después el algoritmo de detección de jugadas para detectar la jugada realizada más probable en función de la posición actual, las probabilidades de cada pieza en cada casilla y el historial de la partida. La jugada detectada y la nueva posición se devuelven después a la clase RealTimeChessCamera, que renderiza la posición predicha y la muestra en pantalla junto con el flujo de vídeo de la cámara.
Para evitar falsos positivos cuando hay movimiento u oclusiones como la mano del jugador, la clase también incluye un método is_board_stable para detectar cuándo la imagen está estable a partir del historial de fotogramas. El método convierte el fotograma actual a escala de grises y calcula la diferencia absoluta píxel a píxel entre el fotograma actual y el anterior. Una vez obtenida la imagen de diferencias, se aplica un umbral binario para crear una máscara binaria en la que los píxeles con una diferencia superior a un determinado umbral se establecen en 255 (blanco) y el resto en 0 (negro). Después se cuenta la proporción de píxeles blancos de la máscara binaria y se añade a una cola para mantener un registro de las últimas N proporciones. A continuación se calcula la proporción media y, si está por debajo de un determinado umbral, se considera que la imagen está estable y se puede llamar al modelo para predecir la jugada. Este enfoque permite evitar llamar al modelo cuando hay movimiento u oclusiones en la imagen. Sin embargo, a pesar de detectar el movimiento, todavía puede haber oclusiones como la mano del jugador que cubran algunas piezas y dificulten la predicción. Para gestionarlo, la oclusión se detecta a partir del color medio o el brillo de la imagen. Si la diferencia de brillo entre el fotograma actual y el último fotograma estable supera un determinado umbral, se asume que hay una oclusión y no se llama al modelo para predecir la jugada.
El siguiente vídeo muestra un ejemplo de una partida completa utilizando la detección de jugadas en tiempo real con el modelo InceptionV3. Como se puede ver en el vídeo, el modelo es capaz de predecir las jugadas realizadas en tiempo real con una buena exactitud, a pesar de la baja calidad de la cámara, las condiciones de iluminación y las oclusiones constantes, como la mano del jugador al realizar la jugada. Al ejecutar el script, aparecen los dispositivos de cámara disponibles y, tras seleccionar la cámara deseada, el usuario debe seleccionar las 4 esquinas del tablero en el fotograma de la cámara. Después comienza la detección de jugadas en tiempo real y se muestra en pantalla la posición predicha junto con el flujo de vídeo de la cámara.
Detección de jugadas de ajedrez en tiempo real mediante YOLOv8
El segundo enfoque para la detección de jugadas de ajedrez en tiempo real utiliza el modelo YOLOv8 de Ultralytics para predecir las piezas de cada casilla del tablero. YOLOv8 es un modelo de detección de objetos del estado del arte que puede lograr una elevada exactitud y velocidad. El modelo se implementa mediante la biblioteca Ultralytics, que proporciona una interfaz sencilla para entrenar y desplegar modelos YOLO. El modelo se entrena para detectar las mismas 13 clases que los modelos anteriores mediante aprendizaje por transferencia, pero también predice los cuadros delimitadores de las piezas en la imagen.
Para entrenar el modelo YOLOv8, es necesario preparar el conjunto de datos en formato YOLO. Para ello, se utiliza la plataforma Roboflow para facilitar el proceso de anotación y exportación. Las imágenes de data/recorded_dataset/video_id/irl se suben a Roboflow y después se anotan mediante su herramienta de anotación. Las anotaciones se realizan dibujando cuadros delimitadores alrededor de cada pieza de la imagen y asignando la etiqueta de clase correspondiente. Una vez anotadas las imágenes, se dividen en conjuntos de entrenamiento, validación y prueba y después se exportan en formato YOLOv8. El conjunto de datos exportado se descarga y se descomprime en el directorio data/roboflow_chess_dataset.
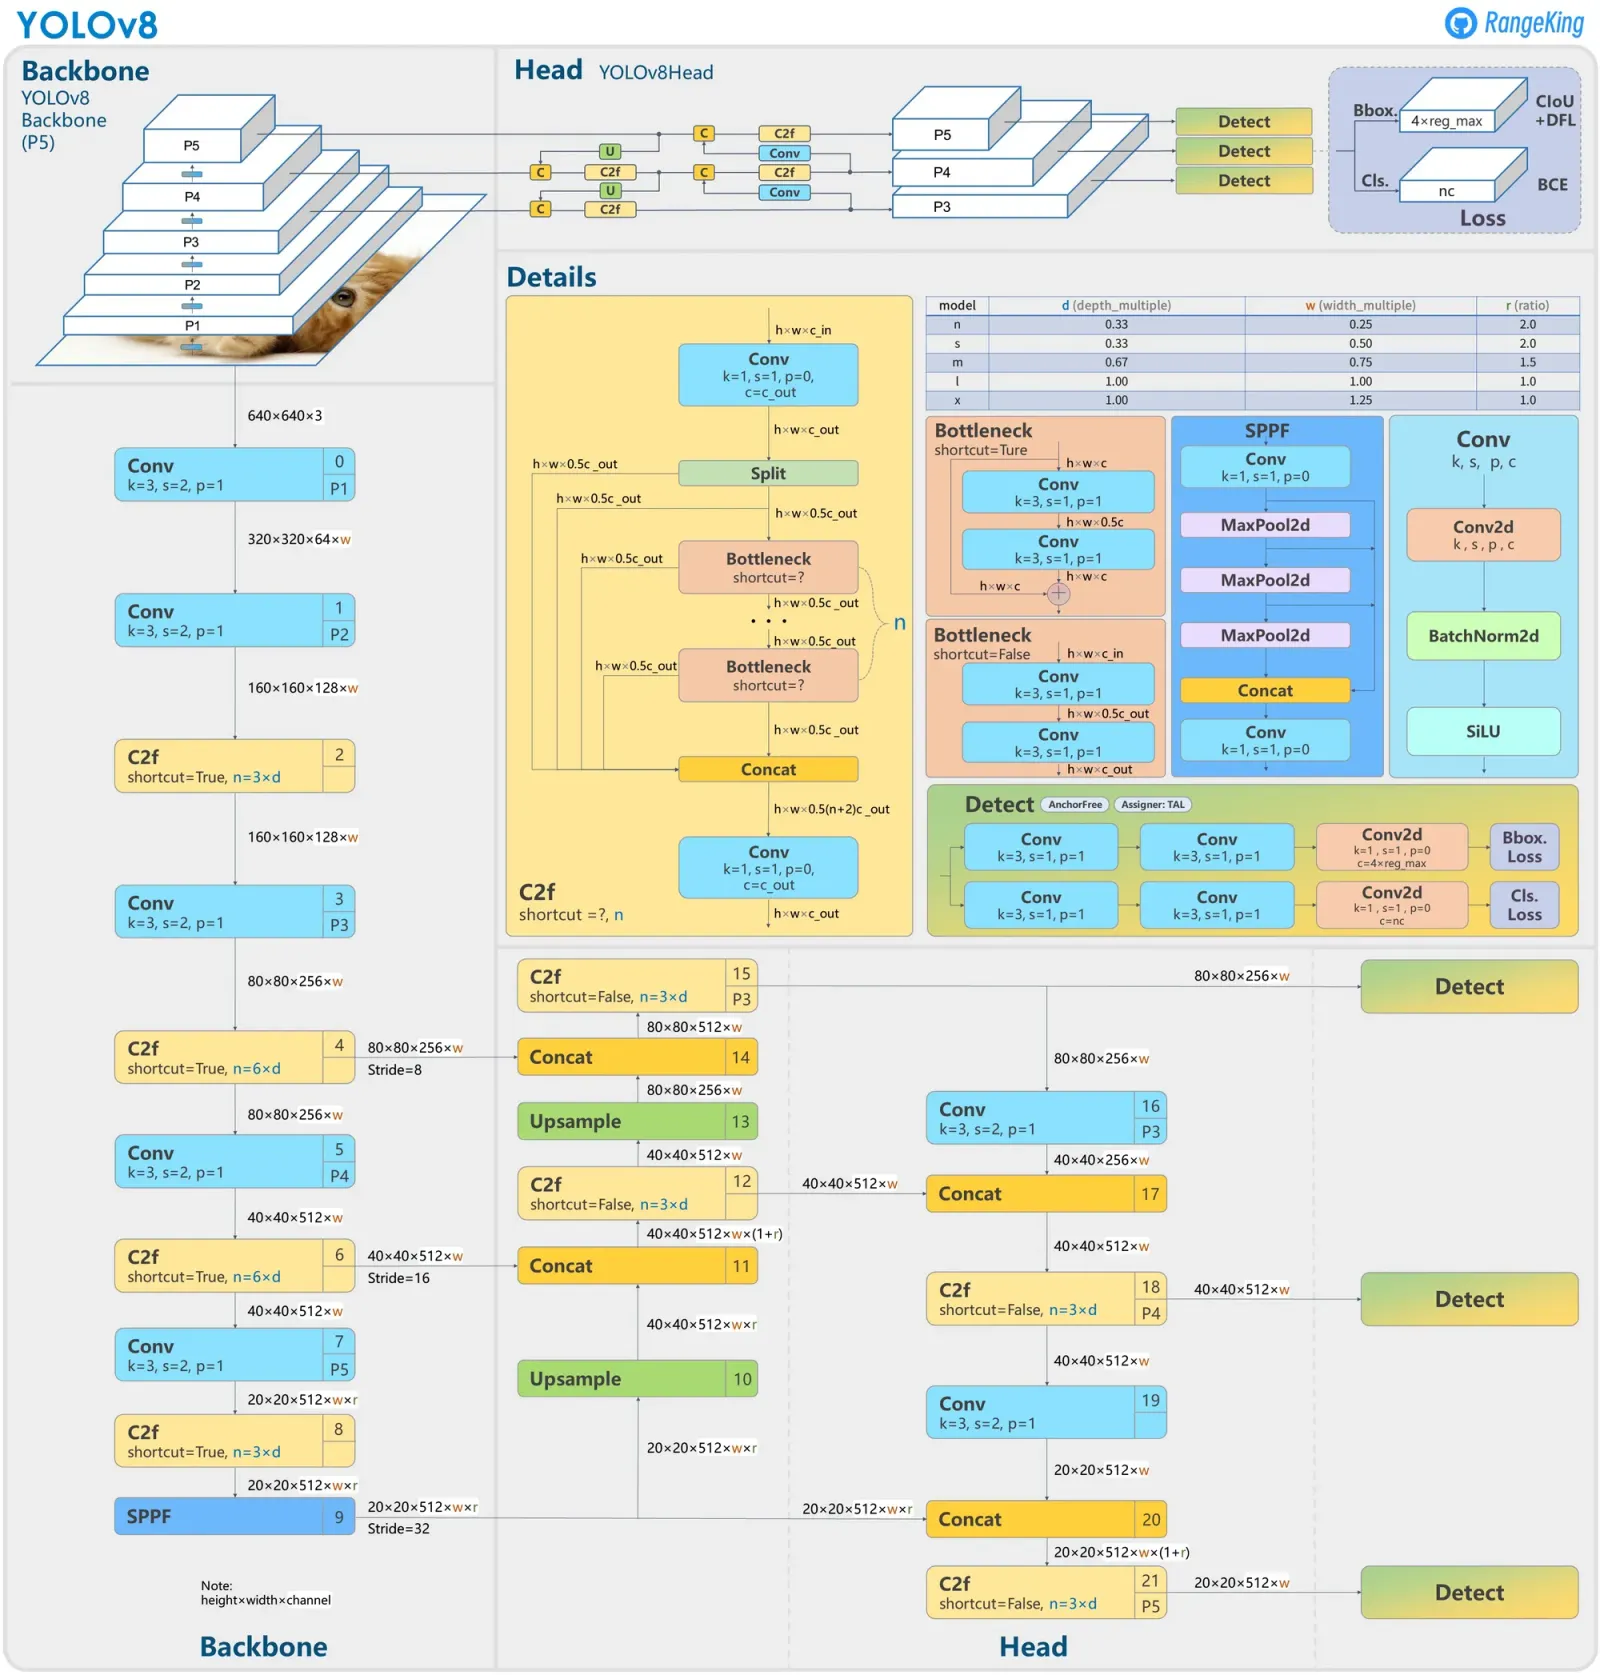
Una vez preparado el conjunto de datos, el modelo YOLOv8 se entrenó en Colab utilizando una GPU T4 durante 100 épocas. Entre los modelos YOLOv8 disponibles, se utilizó YOLOv8m (mediano) como modelo base, que ofrece un buen equilibrio entre exactitud y velocidad. YOLOv8 es un modelo muy potente, pero también complejo, como se puede ver en el siguiente diagrama de arquitectura. La arquitectura se divide en tres partes principales: Backbone, Neck y Head, donde Backbone se encarga de extraer características de la imagen de entrada, Neck se encarga de agregar las características de distintas capas y Head se encarga de predecir los cuadros delimitadores y las etiquetas de clase. Estas partes también se pueden descomponer en módulos más específicos llamados bloques Convolutional, C2F, Bottleneck, SPPF y Detect. Como se ve en el diagrama, el bloque Convolutional consiste en una capa convolucional 2D seguida de una normalización por lotes y una función de activación SiLU. El bloque C2F, por su parte, consiste en una serie de capas convolucionales con conexiones residuales y concatenaciones, y los bloques Bottleneck son una secuencia de bloques convolucionales con una conexión de atajo similar a ResNet si shortcut=True. Finalmente, el bloque SPPF es una capa de agrupación piramidal espacial que concatena las salidas de varias capas de agrupación máxima con distintos tamaños de núcleo para capturar características a diferentes escalas, y el bloque Detect se encarga de predecir los cuadros delimitadores y las etiquetas de clase mediante cuadros de anclaje y una serie de capas convolucionales. A diferencia de las versiones anteriores de YOLO, YOLOv8 utiliza detección sin anclajes, lo que simplifica el modelo y mejora su rendimiento. Se pueden encontrar más detalles sobre la arquitectura y los módulos en [8] y [9].
El proceso de entrenamiento incluye técnicas de aumento de datos para mejorar la robustez del modelo y disponer de suficientes datos para lograr un buen rendimiento. Entre ellas se incluyen rotaciones aleatorias de 90º, volteos y variaciones de escala. Las siguientes imágenes muestran las gráficas de entrenamiento, la distribución de los datos y la matriz de confusión:
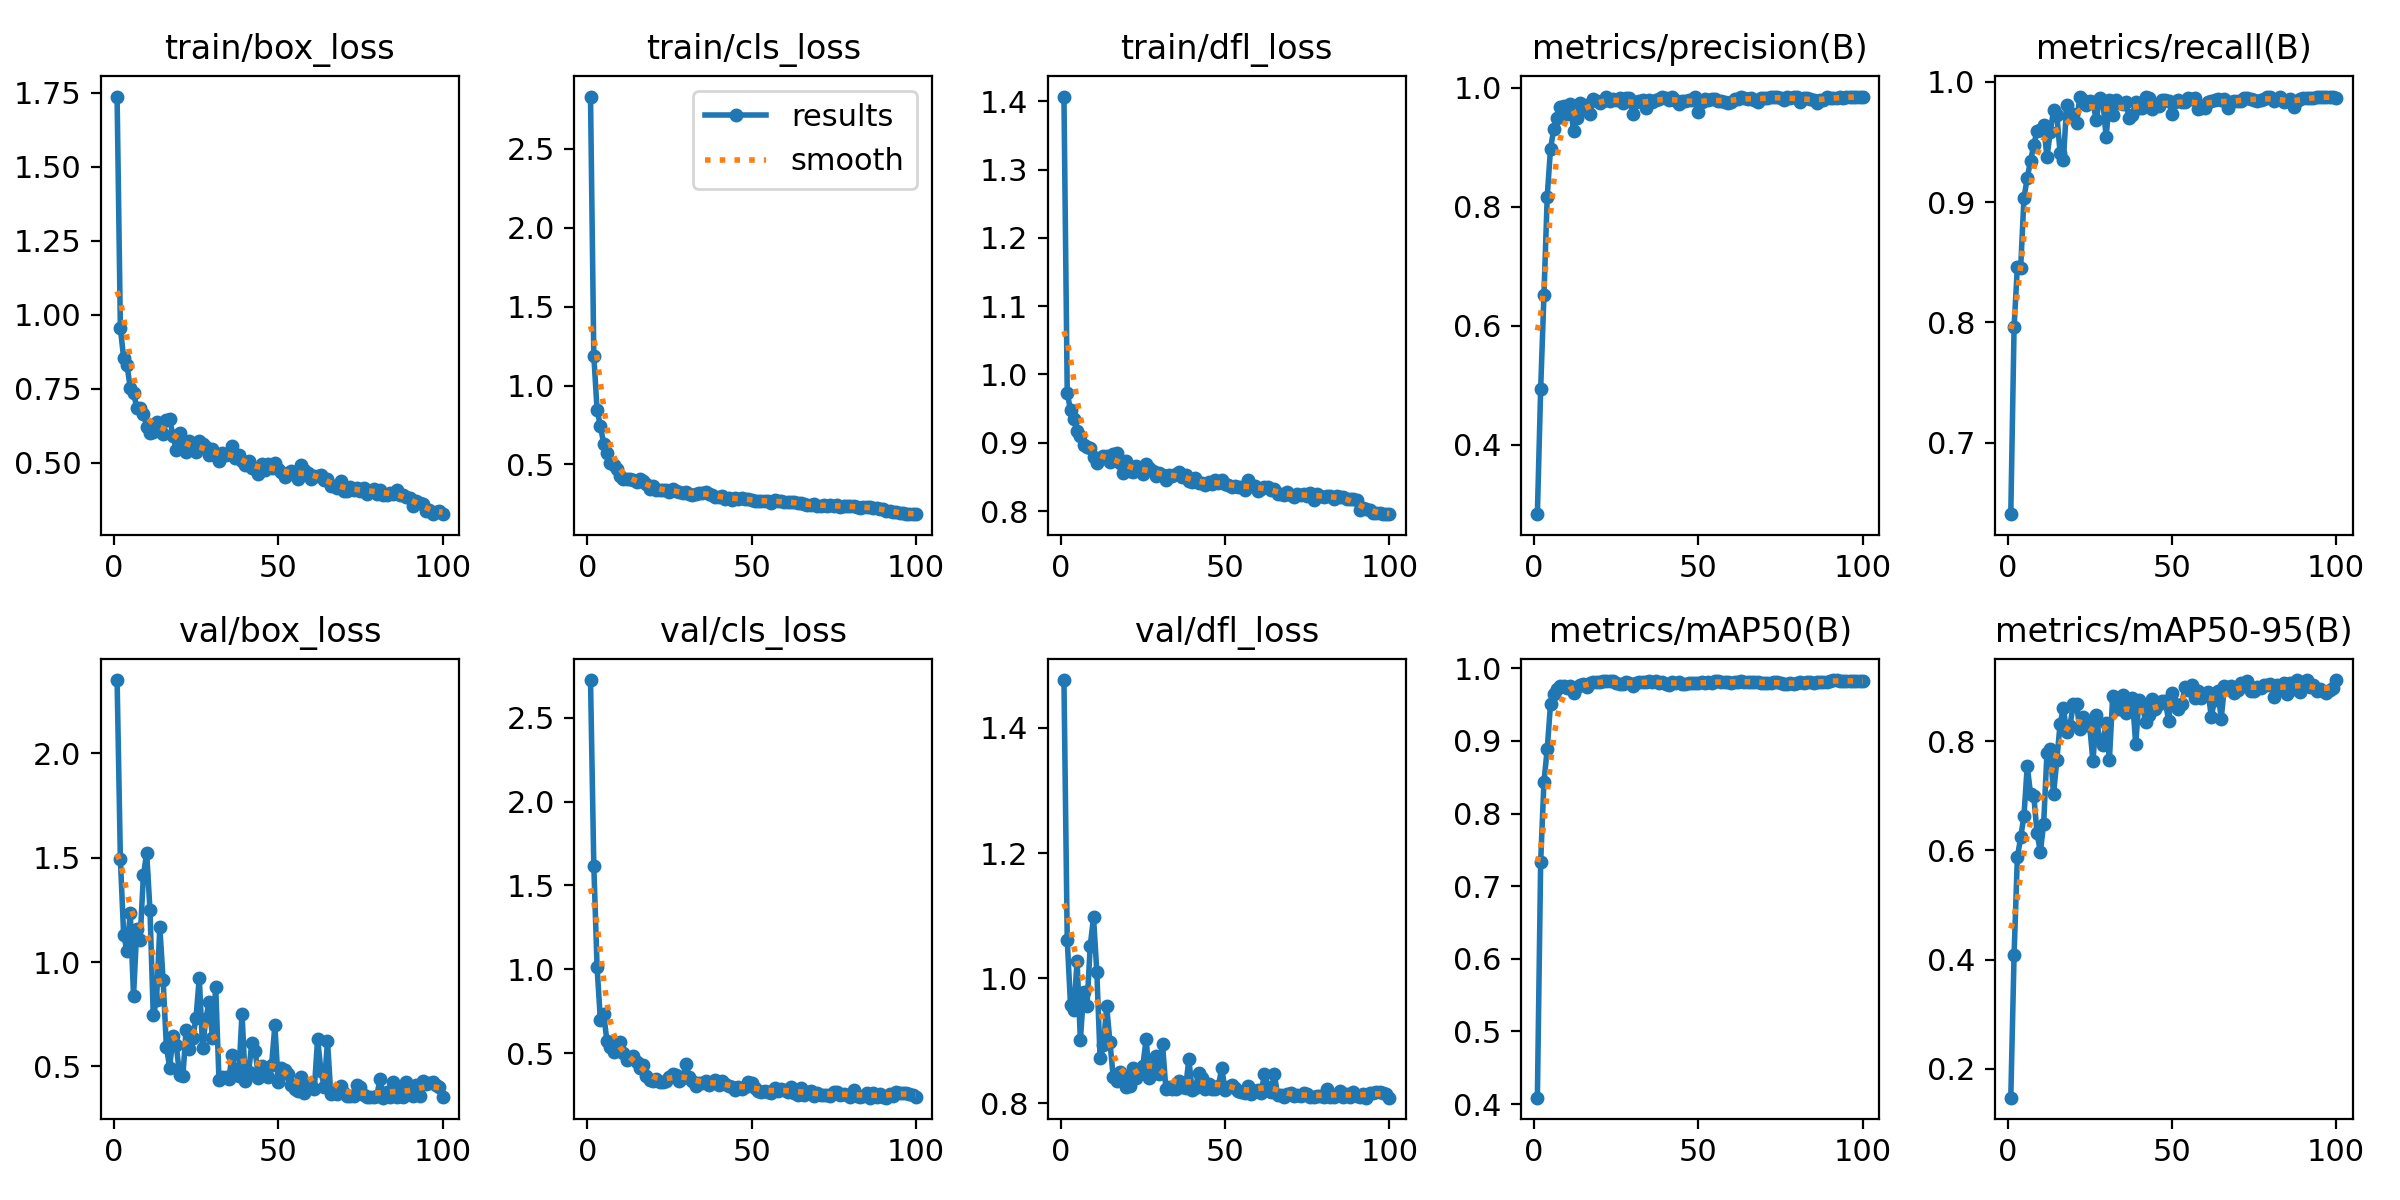
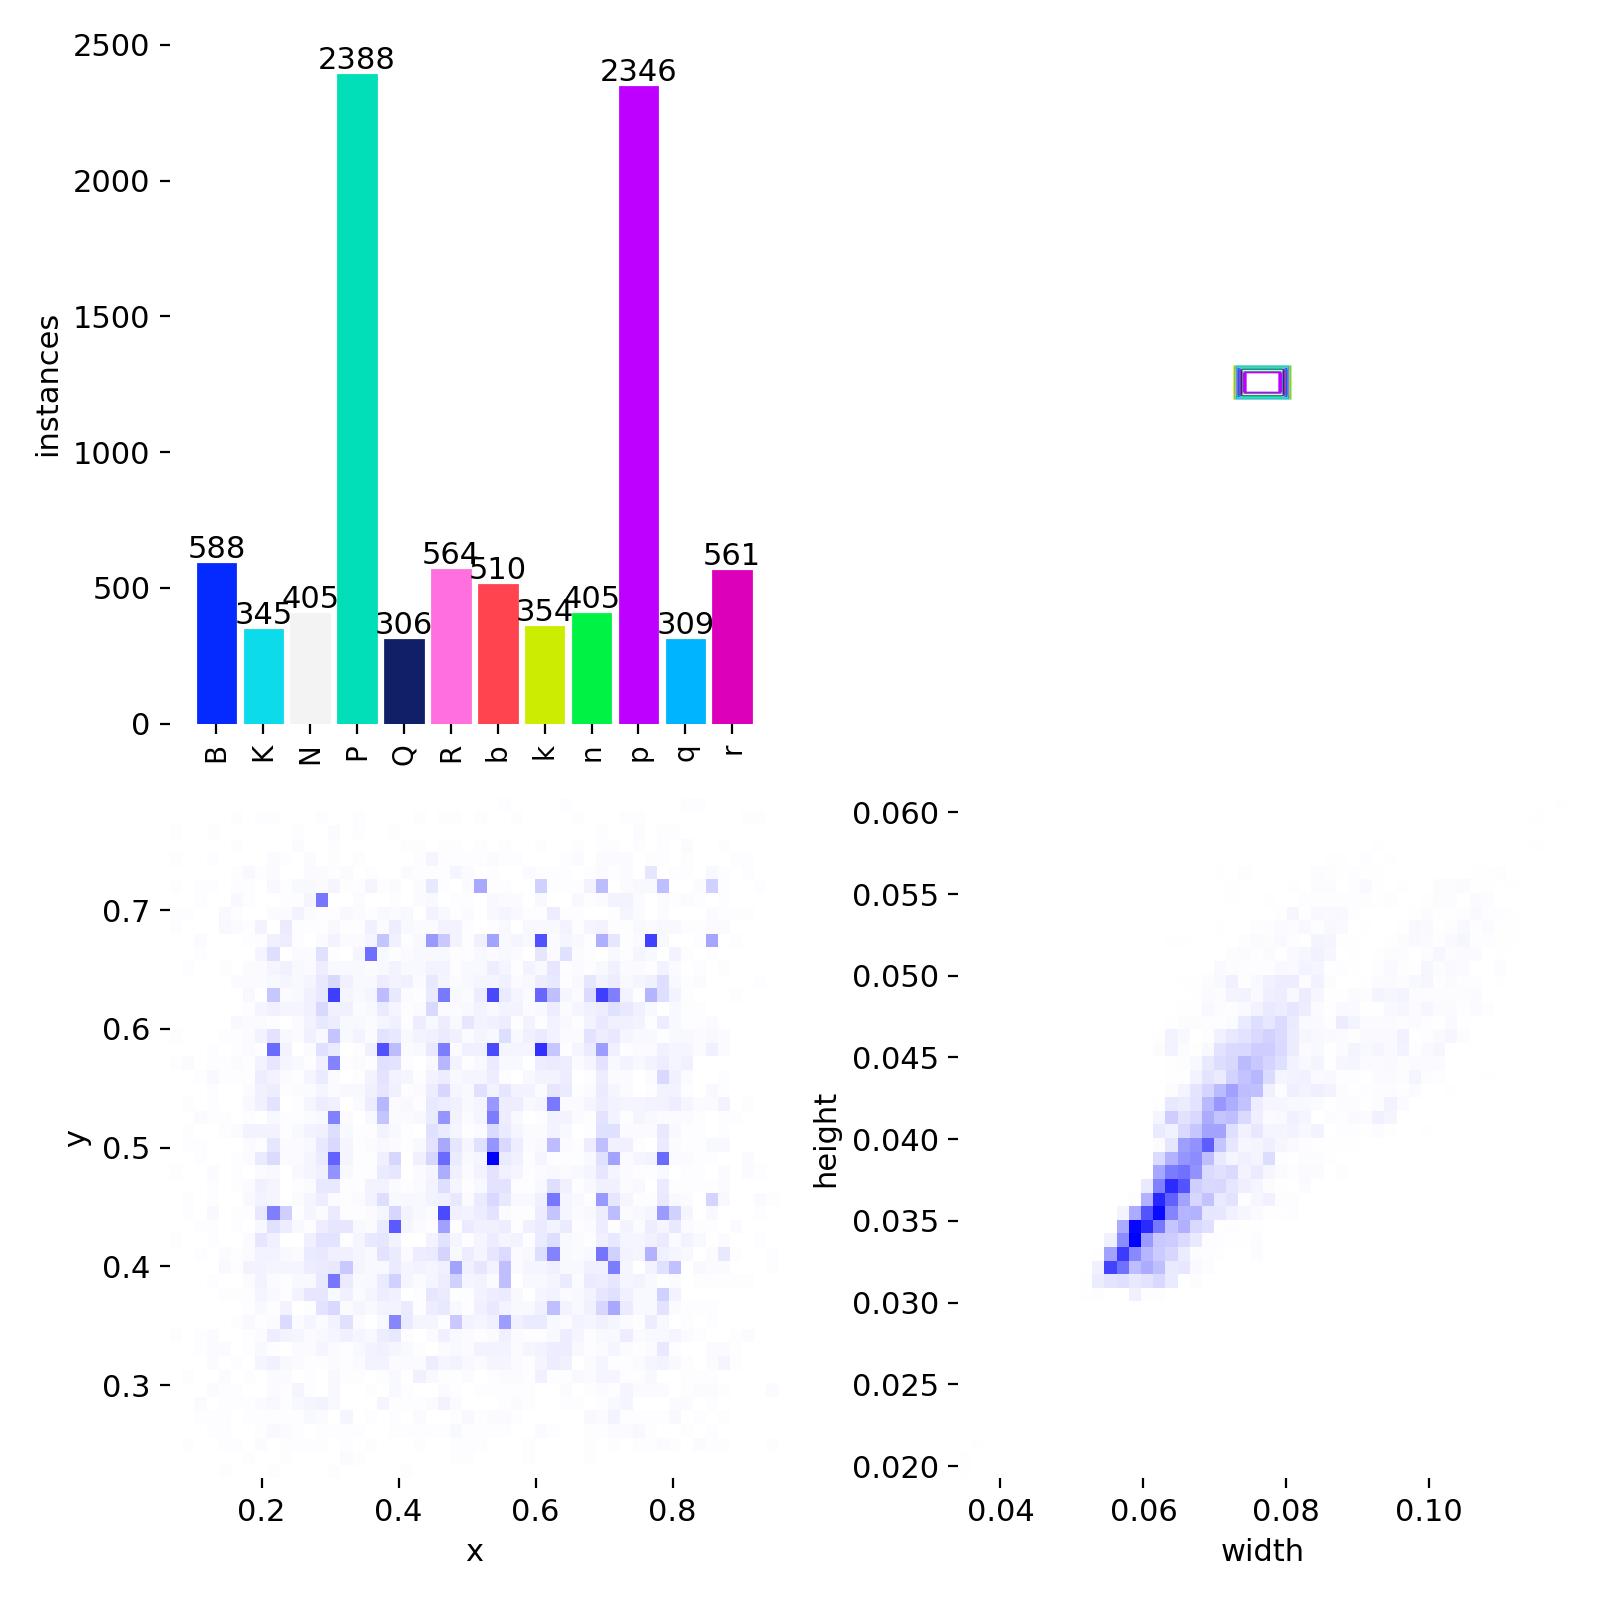
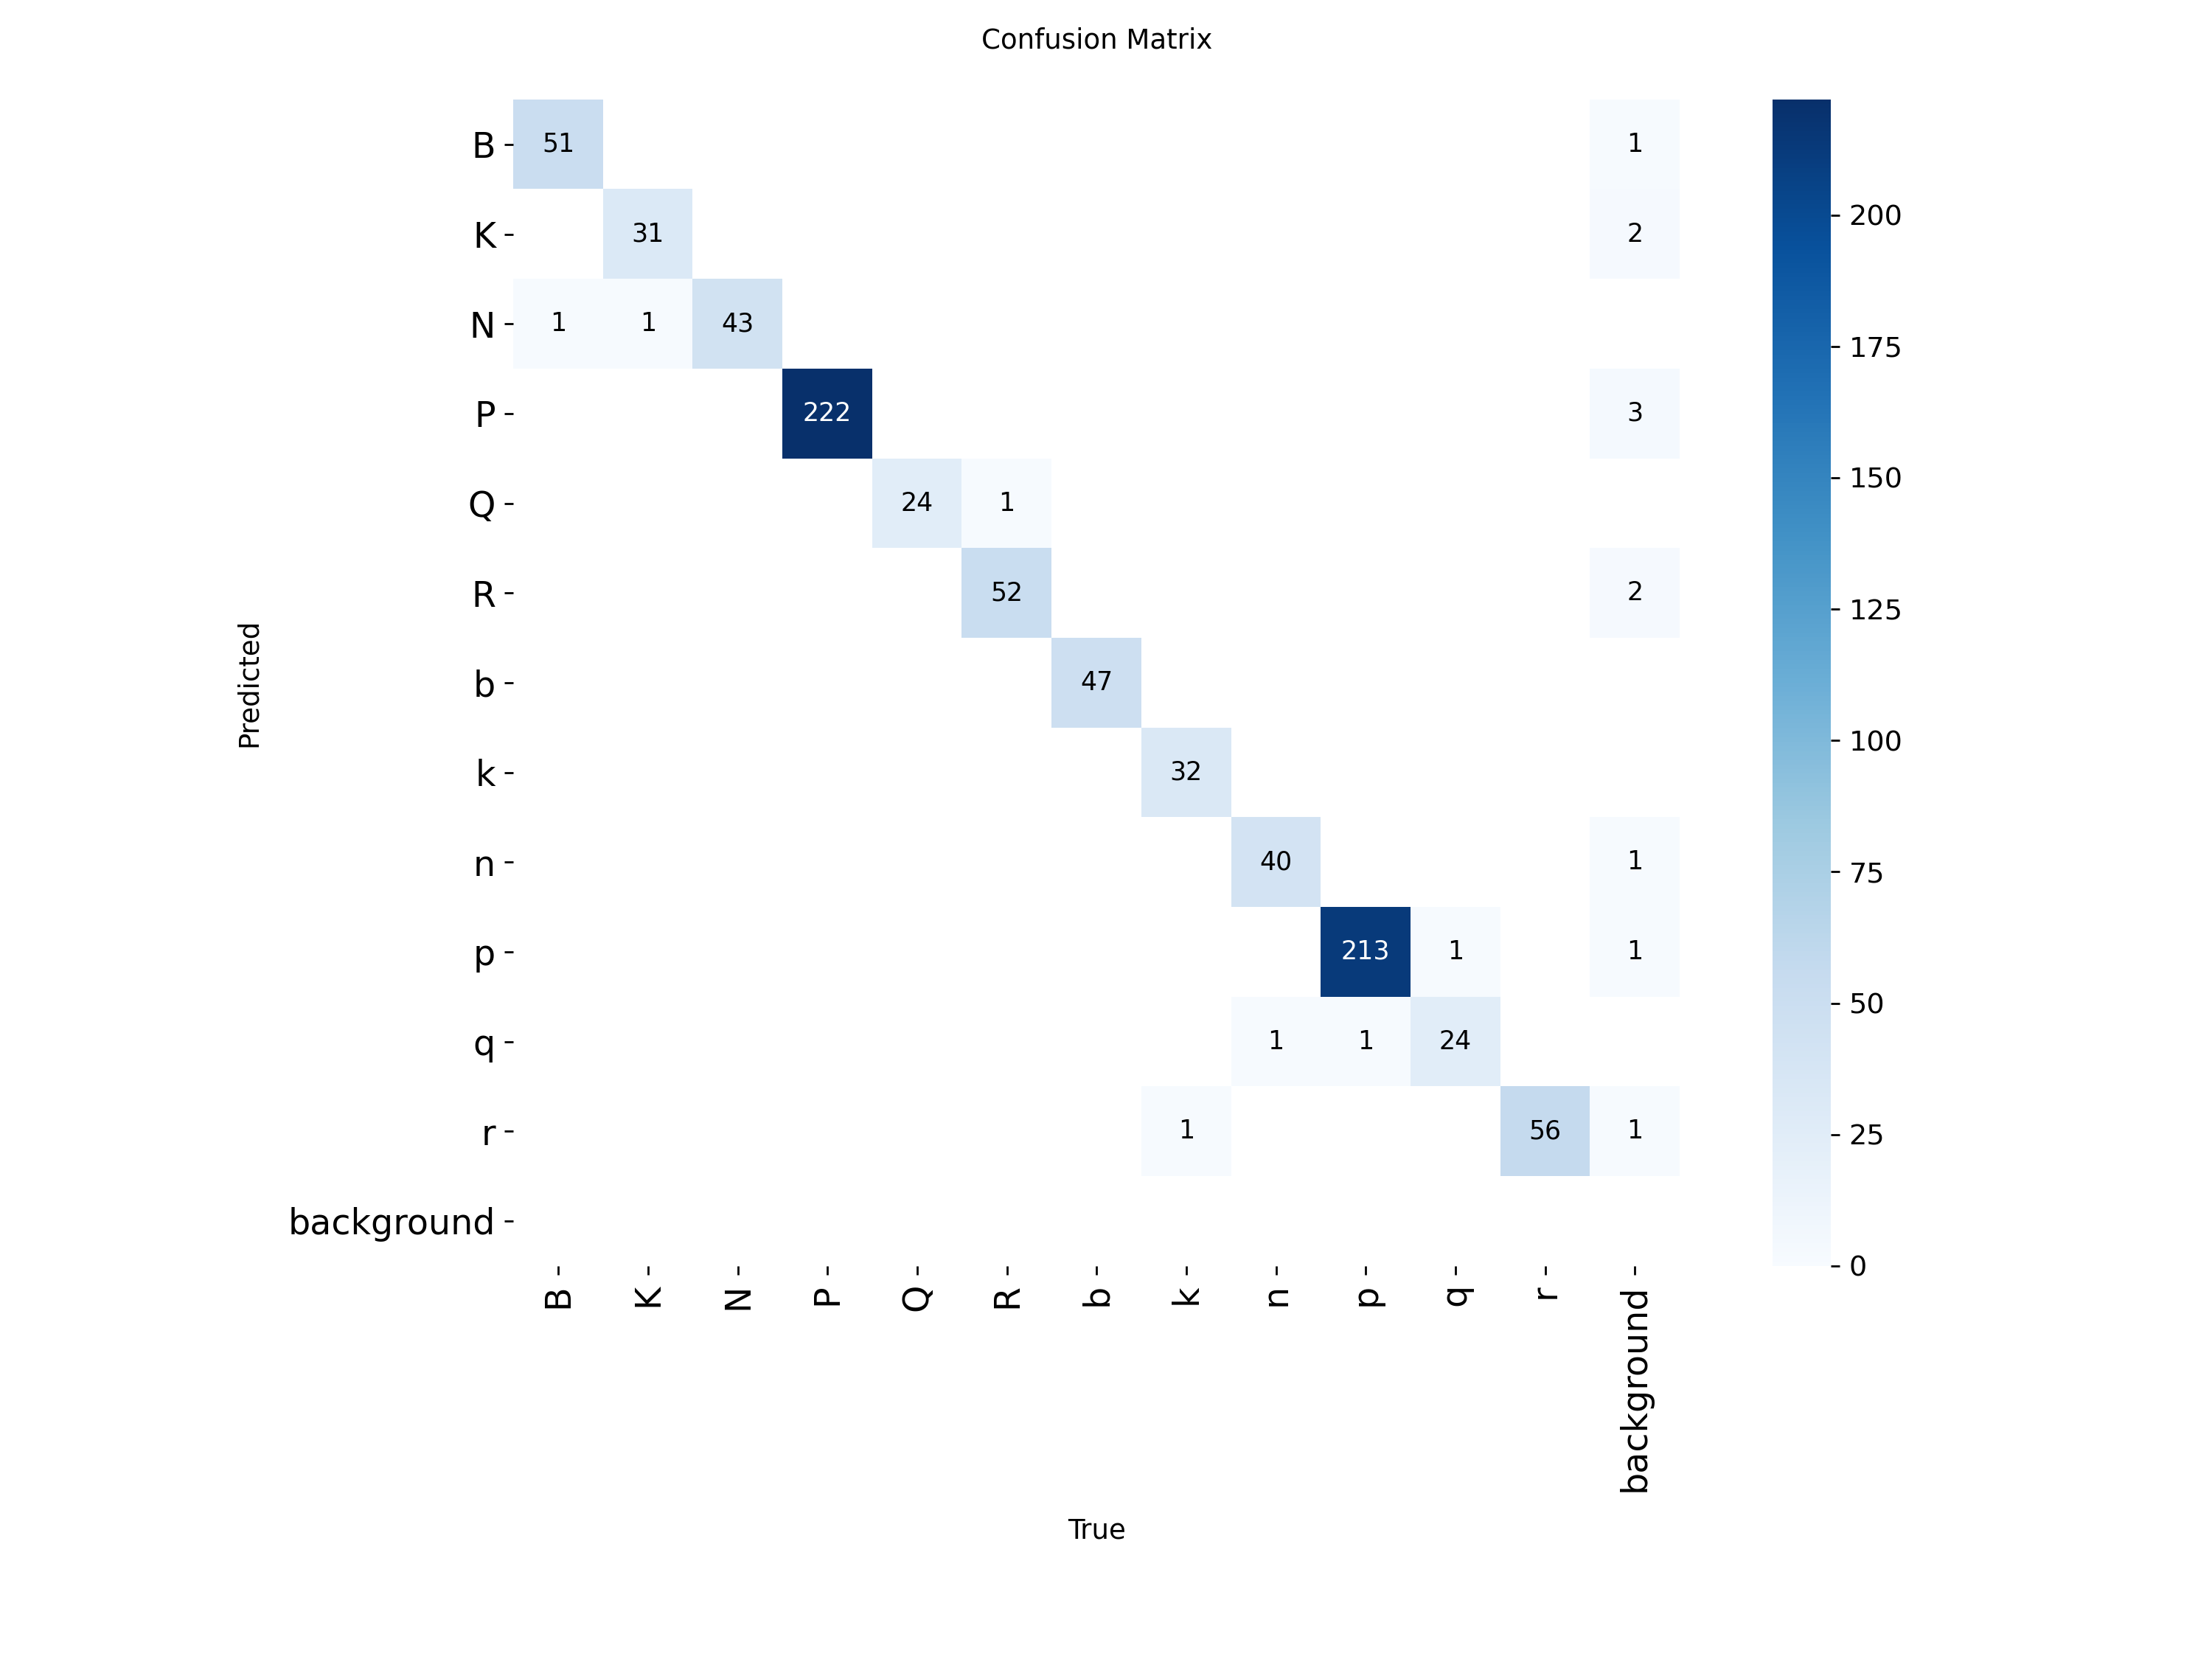
La distribución de los datos muestra cierto desequilibrio entre las clases, ya que hay muchos más peones (P, p) que otras piezas, mientras que el resto de las piezas tiene un número similar de instancias. Este es un problema habitual en una partida de ajedrez, ya que hay 8 peones por bando al inicio de cada partida normal. Por otro lado, las métricas de entrenamiento muestran un buen rendimiento del modelo durante el entrenamiento y la validación, con una buena convergencia y sin sobreajuste, a pesar de algunas fluctuaciones en la pérdida de validación. Los valores finales de entrenamiento de [email protected] y mAP@95 son 0.982 y 0.911, respectivamente, mientras que los de validación son 0.982 y 0.916, respectivamente, lo que indica una buena generalización del modelo. Finalmente, la matriz de confusión muestra un gran rendimiento del modelo en general, con algunas clasificaciones erróneas individuales ocasionales entre ciertas piezas.
La ventaja de utilizar YOLOv8 en comparación con un clasificador CNN normal como InceptionV3 es que se puede utilizar para detectar las piezas en la imagen completa del tablero, en lugar de recortar cada casilla y predecir su pieza. Esto puede mejorar potencialmente la exactitud del modelo, ya que los recortes pueden perder información y contexto de las piezas. Este problema se amplifica con el ángulo de la cámara y la alineación imperfecta del tablero. Mediante este enfoque, el modelo puede aprender a detectar las piezas en el contexto del tablero completo y no solo en el de cada casilla. Sin embargo, este enfoque requiere un paso adicional para asociar los cuadros delimitadores detectados con las casillas correspondientes del tablero.
cd src
python 05b_finetune_yolo_detector.py
Los resultados del modelo YOLOv8 son los cuadros delimitadores de las piezas detectadas junto con su clase y puntuación de confianza. Como en el enfoque anterior, se calcula una transformación de perspectiva mediante OpenCV al seleccionar las esquinas del tablero en la ventana de OpenCV que abre el script src/06_yolo_real_time_detection.py para la detección en tiempo real. La correspondencia entre los cuadros delimitadores y las casillas se realiza calculando el centro de cada cuadro y el centro de cada casilla del tablero. El centro de cada casilla se puede calcular fácilmente en el espacio del tablero cuadrado transformado, suponiendo que todas las casillas tienen el mismo tamaño. El siguiente paso consiste en aplicar la transformación de perspectiva inversa para obtener el centro de cada casilla en la imagen original y, finalmente, asignar cada detección a la casilla con el centro más cercano mediante el algoritmo húngaro de la función scipy.optimize.linear_sum_assignment.
cd src
python 06_yolo_real_time_detection.py
Una vez asignadas las piezas a las casillas, es necesario calcular las probabilidades de cada pieza en cada casilla a partir de las puntuaciones de confianza de las detecciones. La detección propiamente dicha la realiza la clase RTChessboardPredictor, que es idéntica a la utilizada en el enfoque de InceptionV3, salvo por el método predict_gt_board, que se modifica para utilizar el modelo YOLOv8 para detectar las piezas en la imagen completa del tablero y después asociar las detecciones con las casillas mediante el método descrito anteriormente. Aquí las probabilidades se calculan a partir de las puntuaciones de confianza de las detecciones. Si una casilla tiene una detección asignada, la probabilidad de la pieza detectada se establece en la puntuación de confianza y las probabilidades de las demás piezas se establecen en un valor pequeño (1 - puntuación de confianza) / 12. Si una casilla no tiene ninguna detección asignada, la probabilidad de la clase vacía se establece en 1 y las probabilidades de las demás piezas se establecen en 0.
Por encima de la clase de detección de jugadas se encuentra la clase RealTimeChessCamera, que también es idéntica a la utilizada en el enfoque de InceptionV3. Se encarga de gestionar el flujo de la cámara y procesar los fotogramas, detectar oclusiones o movimiento para evitar llamar al modelo cuando un jugador está realizando una jugada y llamar al método predict de la clase RTChessboardPredictor para predecir las jugadas. El siguiente vídeo muestra un ejemplo de una partida completa utilizando la detección de jugadas en tiempo real con el modelo YOLOv8. Como se puede ver en el vídeo, el modelo es capaz de predecir las jugadas realizadas en tiempo real con una buena exactitud, a pesar de la baja calidad de la cámara y las oclusiones constantes de la mano del jugador al realizar la jugada.
Al ejecutar el script, aparecen los dispositivos de cámara disponibles y, tras seleccionar la cámara deseada, el usuario debe seleccionar las 4 esquinas del tablero en el fotograma de la cámara. Después comienza la detección de jugadas en tiempo real y se muestra en pantalla la posición predicha junto con el flujo de vídeo de la cámara y los cuadros delimitadores de las piezas detectadas en la imagen del tablero. El resultado es una detección completa de jugadas de ajedrez en tiempo real, a pesar de algunas clasificaciones erróneas entre dama y alfil en ciertos casos.
Agradecimientos
- [1] Rob Mulla, https://github.com/RobMulla/chessboard-vision, 2022.
- [2] Simon J.D. Prince, “Understanding Deep Learning”, 2023.
- [3] Laurence Moroney, “AI and ML for Coders in PyTorch”, 2025.
- [4] Christian Szegedy, Vincent Vanhoucke, Sergey Ioffe, Jonathon Shlens, Zbigniew Wojna, “Rethinking the Inception Architecture for Computer Vision”, 2015.
- [5] Maciej A. Czyzewski, Artur Laskowski, Szymon Wasik, “Chessboard and Chess Piece Recognition With the Support of Neural Networks”, 2020.
- [6] David Mallasén Quintana, Alberto Antonio del Barrio García, Manuel Prieto Matías, “LiveChess2FEN: a Framework for Classifying Chess Pieces based on CNNs”, 2020.
- [7] James Gallagher, “Roboflow: Represent Chess Boards Digitally with Computer Vision”, 2023.
- [8] Jacob Solawetz, Francesco, https://blog.roboflow.com/what-is-yolov8/, 2024.
- [9] Dr. Priyanto Hidayatullah, https://www.youtube.com/watch?v=HQXhDO7COj8, 2023.
- [10] Think Autonomous, https://www.thinkautonomous.ai/blog/hungarian-algorithm/, 2023.