Aprendizaje por refuerzo para sistemas de control de vuelo
Este repositorio implementa aprendizaje profundo por refuerzo para entrenar sistemas de control de vuelo (FCS) para una aeronave de ala fija. El proyecto incluye un simulador, una aplicación web para probar el simulador mediante entradas de teclado y un entorno completo para entrenar agentes de RL. Este entorno se utiliza para entrenar agentes mediante el algoritmo Proximal Policy Optimization (PPO) de la biblioteca Stable Baselines3 para seguir trayectorias de vuelo específicas dadas por puntos de paso.
Requisitos e instalación
Clona el repositorio:
git clone <repository-url>
cd rl-fcs
Para configurar el entorno, necesitas instalar los paquetes de Python necesarios. Puedes hacerlo mediante pip:
pip install -r requirements.txtPara la integración con Weights & Biases (WandB), necesitas iniciar sesión en tu cuenta de WandB o descomentar las líneas correspondientes en el script de entrenamiento para el modo sin conexión. Si utilizas el modo en línea, también necesitas crear un nuevo proyecto en WandB llamado rl-fcs y establecer la entidad con tu nombre de usuario o de equipo en training/waypoint/train_waypoint_control.py.
wandb loginPara utilizar la aplicación web, accede al directorio web-app e instala Node si aún no lo has hecho. Después, instala los paquetes de npm necesarios siguiendo las instrucciones del archivo web-app/README.md. Estos son los pasos principales:
cd simulator_webapp
npm install
Para ejecutar la aplicación web, utiliza:
npm run devSimulador
Para disponer de un modelo de dinámica de vuelo (FDM) de la aeronave e implementar el entorno, se desarrolló un simulador sencillo en Python utilizando las ecuaciones del movimiento linealizadas a partir de una condición de referencia e integrándolas mediante un método de Runge-Kutta de cuarto orden. Los pasos completos para deducir las ecuaciones se encuentran en el capítulo 14 del libro [1] y la integración de Runge-Kutta en la página 905 de [2].
Las ecuaciones del movimiento de Euler son el resultado de aplicar el teorema de la cantidad de movimiento y el teorema del momento cinético a un sólido rígido en vuelo. A continuación, utilizando el teorema de Coriolis para expresar la derivada temporal de un sistema de referencia inercial en un sistema de ejes cuerpo, suponiendo que el avión es simétrico, de modo que solo son distintos de cero, y separando finalmente las fuerzas y los momentos en sus componentes de empuje, aerodinámica y peso, obtenemos las siguientes ecuaciones en ejes cuerpo:
Además, las ecuaciones cinemáticas angulares se obtienen proyectando las velocidades angulares de Euler de cada eje de rotación de Tait-Bryan sobre el sistema de ejes cuerpo:
Finalmente, las ecuaciones cinemáticas de traslación se obtienen proyectando las velocidades del sistema de ejes cuerpo sobre el sistema de referencia inercial:
Estas ecuaciones se linealizan después alrededor de una condición de referencia que consiste en un vuelo estacionario, rectilíneo, simétrico y con las alas niveladas, suponiendo ejes de estabilidad () y :
A partir de esta condición de referencia, se aplica una perturbación a cada variable de estado, por ejemplo , y, tras despreciar los términos de segundo orden, se obtienen las ecuaciones linealizadas del movimiento:
El siguiente paso tras obtener las ecuaciones linealizadas del movimiento es expresar las fuerzas y los momentos aerodinámicos en función de las variables de estado y sus derivadas. Este proceso se conoce como método de Bryan y consiste en agrupar las perturbaciones de las fuerzas y los momentos aerodinámicos y de empuje y expresarlas en términos de derivadas de estabilidad, que son los coeficientes que relacionan el cambio en las fuerzas y los momentos con un cambio en cada variable de estado o deflexión de las superficies de control. Tras algunas simplificaciones e hipótesis, cada fuerza y momento se puede expresar de la siguiente manera:
Finalmente, la representación en el espacio de estados se obtiene reordenando las ecuaciones linealizadas del movimiento y sustituyendo las expresiones de las perturbaciones de las fuerzas y los momentos. Las ecuaciones longitudinales y laterales-direccionales se desacoplan debido a las hipótesis de simetría y a que las derivadas de estabilidad de acoplamiento cruzado son pequeñas o despreciables. Las ecuaciones longitudinales proporcionan la evolución de , que representan el movimiento en el plano vertical (movimiento de cabeceo), mientras que las ecuaciones laterales-direccionales proporcionan la evolución de , que representan el movimiento en los ejes lateral (alabeo) y direccional (guiñada).
Para implementar el simulador, cada representación longitudinal y lateral-direccional en el espacio de estados se expresa en forma matricial y se resuelve numéricamente mediante un método de Runge-Kutta de cuarto orden. La implementación completa se encuentra en envs/core/simulator.py. Para obtener las matrices se utilizó una biblioteca simbólica de Python llamada SymPy para realizar las manipulaciones algebraicas. El método run de la clase Simulator recibe el estado actual y las deflexiones de las superficies de control y devuelve el estado actualizado tras un paso de tiempo. Para calcular la ubicación del avión en el sistema de referencia inercial, también se integran las ecuaciones cinemáticas de traslación utilizando las velocidades en ejes cuerpo calculadas previamente.
La clase Simulator carga una aeronave definida mediante un archivo XML que contiene sus propiedades y derivadas de estabilidad. Se implementó un analizador XML en envs/core/xml_parser.py para leer el archivo de la aeronave, analizar los datos y las unidades de entrada y convertirlas a unidades del SI mediante la biblioteca unyt. Los datos se agrupan en distintas clases utilizando pydantic para su validación y fácil acceso. Dentro de la clase Simulator, el constructor recibe los datos de la aeronave y calcula las matrices del espacio de estados para las ecuaciones longitudinales y laterales-direccionales, evitando recalcularlas en cada paso de tiempo. Además del método run, la clase Simulator también implementa un método get_state para devolver el estado actual de la aeronave y un método reset para restablecer el estado a la condición de referencia.
Aplicación web del simulador
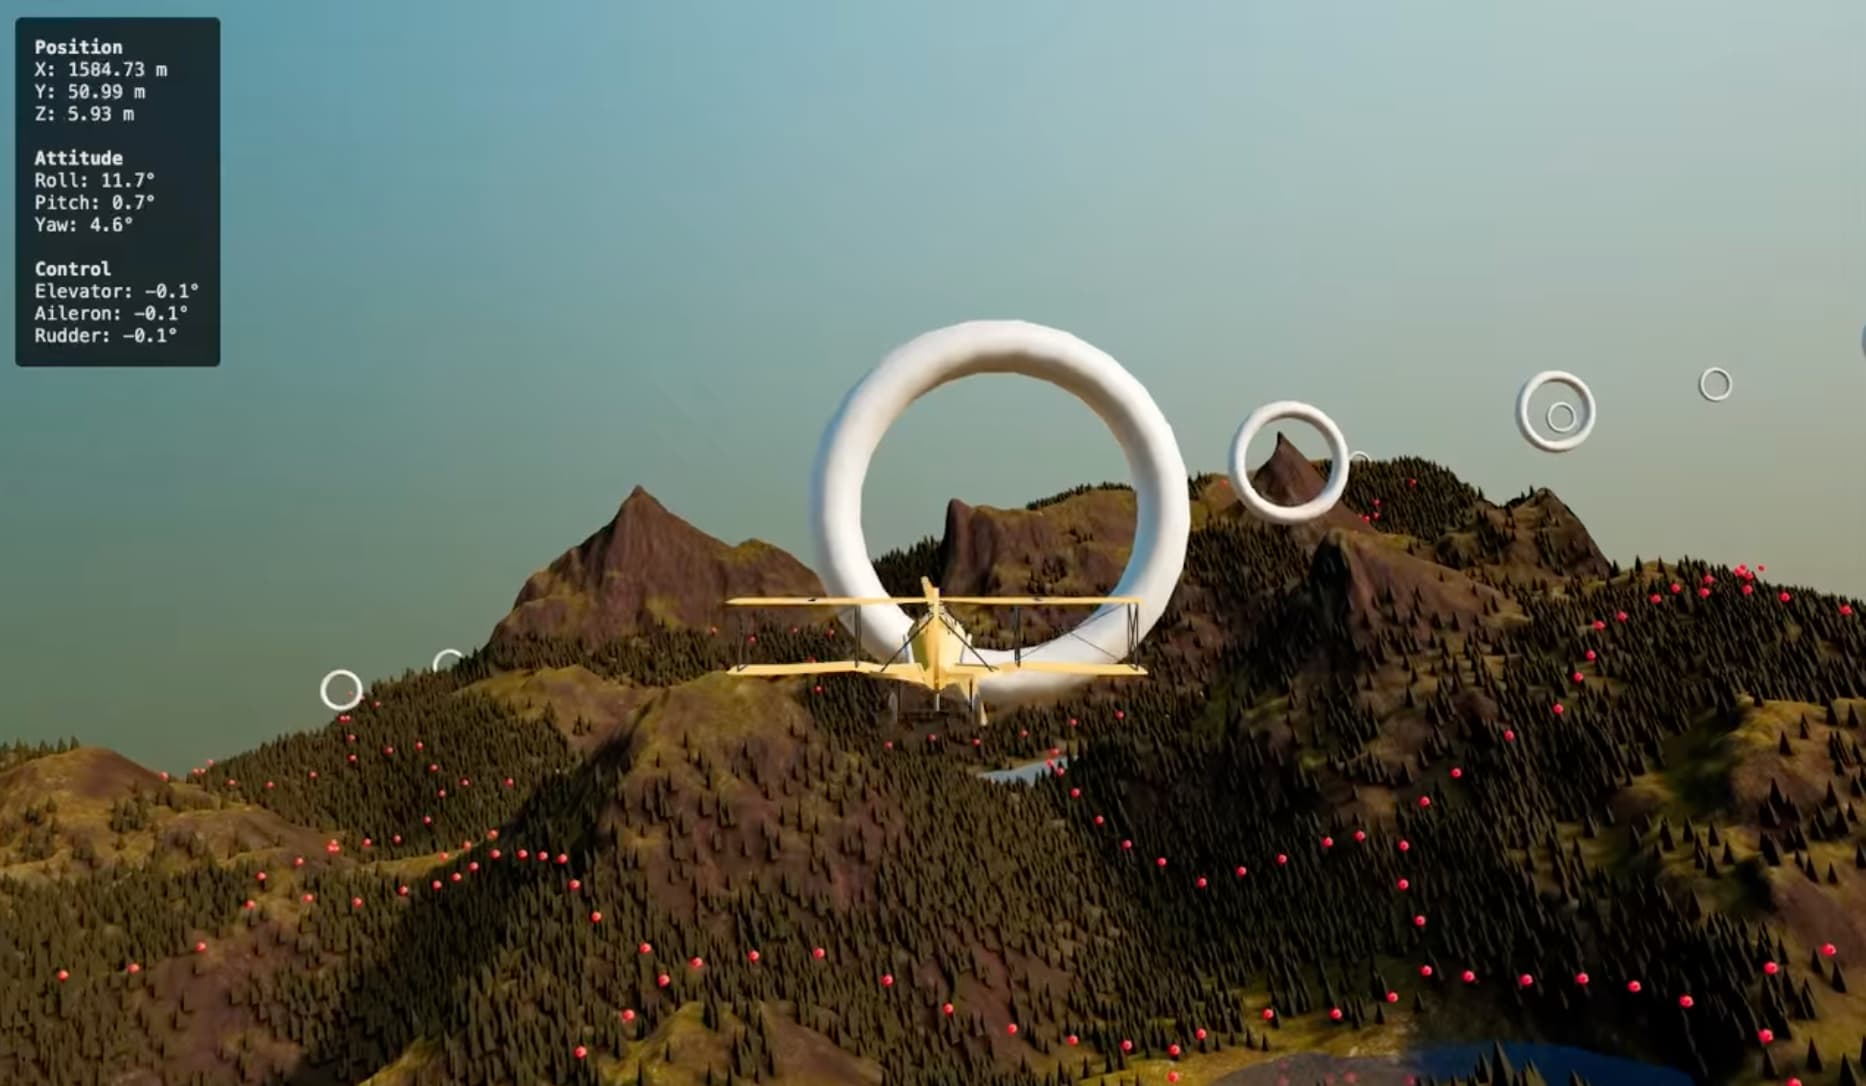
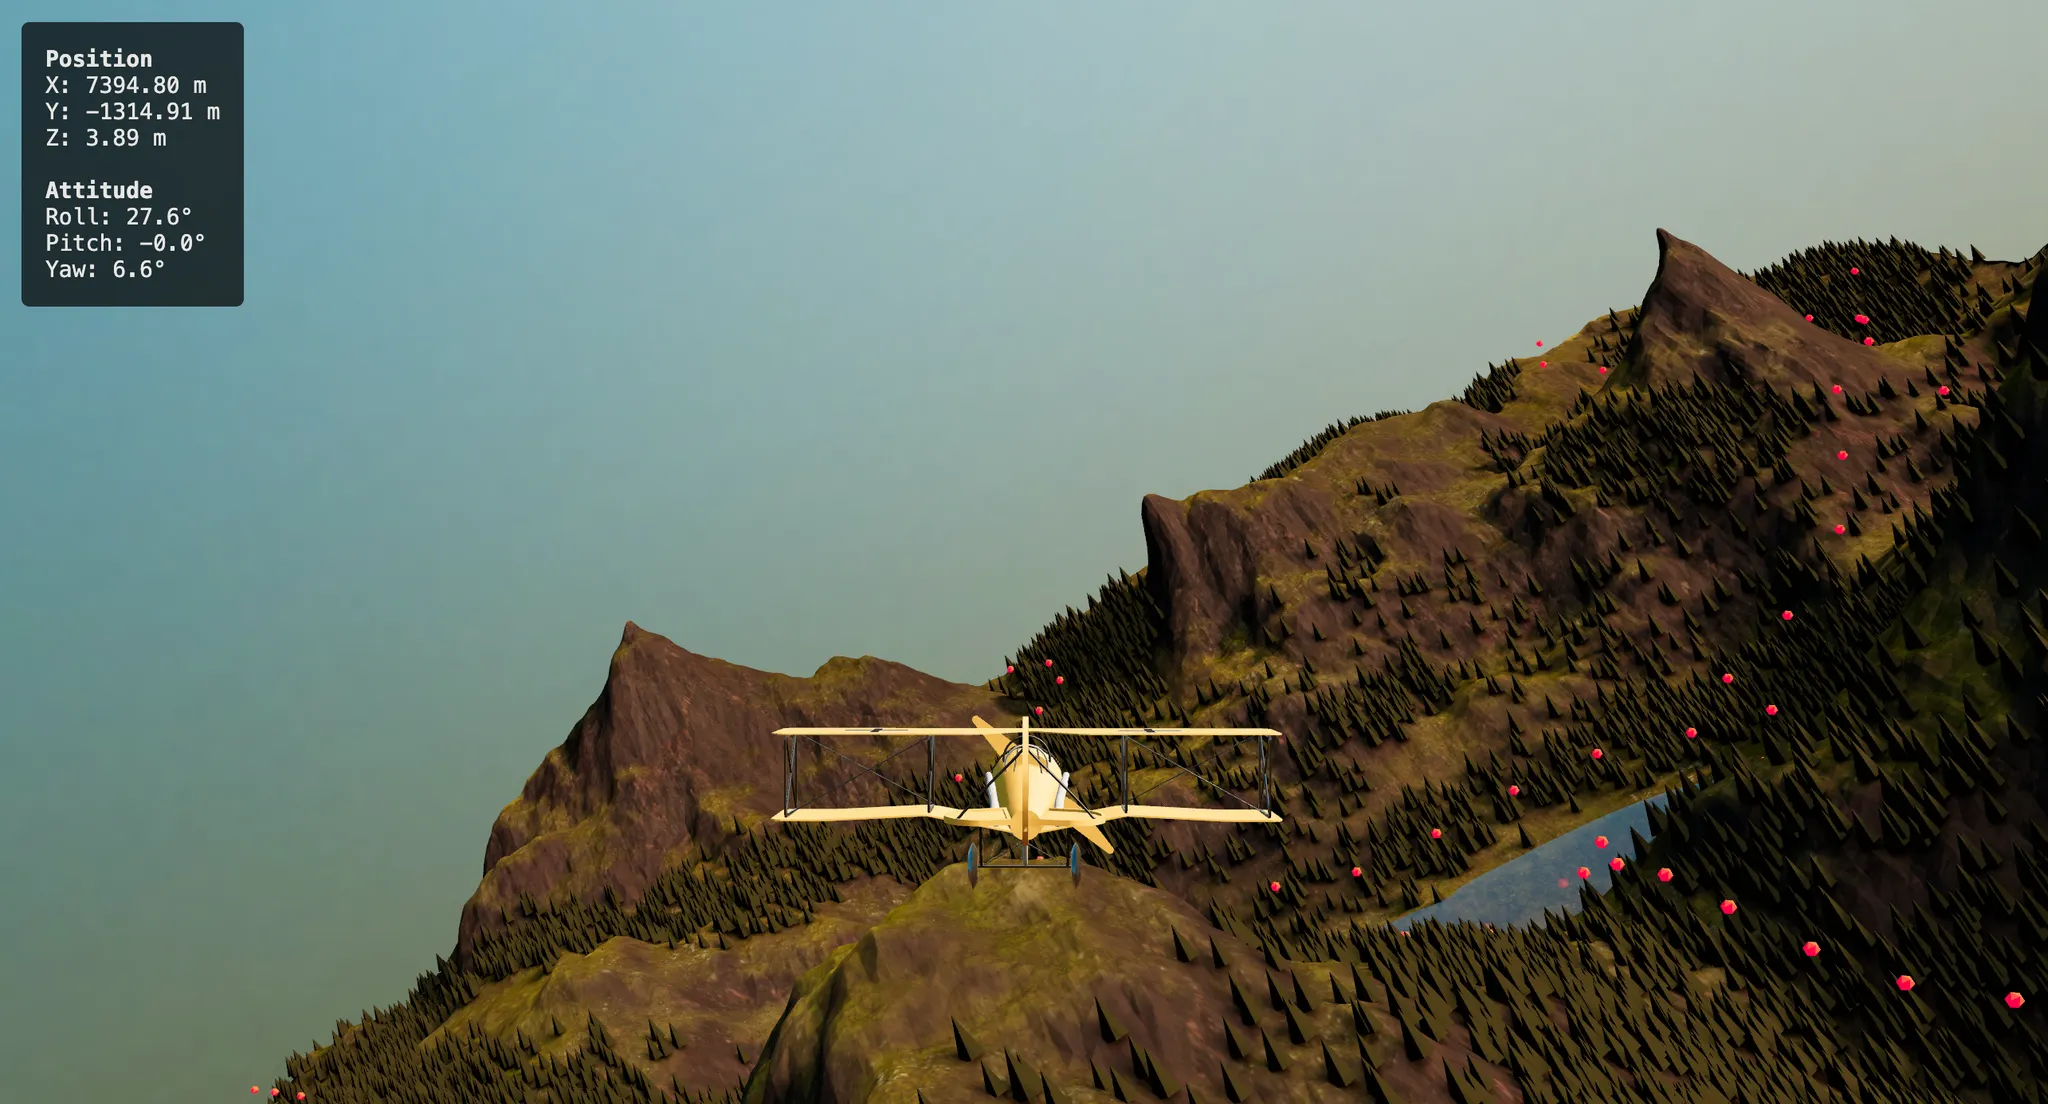
Para visualizar y probar el simulador, se desarrolló una aplicación web utilizando React, Three.js y Vite. La aplicación web permite controlar la aeronave mediante entradas de teclado y ver su respuesta en tiempo real. La aplicación web se creó con fines de validación durante el desarrollo del simulador y del entorno, pero también se puede utilizar como un simulador de vuelo sencillo. Está basada en el proyecto R3F-takes-flight y se comunica con el simulador mediante llamadas a una API REST para enviar las deflexiones de las superficies de control y recibir el estado de la aeronave para actualizar el modelo 3D. A continuación se muestra una imagen de la aplicación web:
La sencilla API REST se implementa utilizando FastAPI y se encuentra en tests/sim_api. Los endpoints principales son /step, para enviar las deflexiones de las superficies de control y recibir el estado actualizado, y /reset, para restablecer el simulador a la condición de referencia y guardar algunos registros en un archivo CSV. El código de la aplicación web se encuentra en el directorio simulator_webapp. Las instrucciones para configurar y ejecutar la aplicación web se encuentran en el archivo simulator_webapp/README.md.
Entorno de RL
El entorno de RL se implementa utilizando la interfaz OpenAI Gym y se encuentra en envs/waypoint_navigation_env.py. El entorno utiliza la clase Simulator para simular la dinámica de la aeronave y proporciona una tarea de navegación por puntos de paso para el agente de RL. El agente debe aprender a controlar la aeronave para seguir una serie de puntos de paso evitando condiciones de fallo como superar los límites máximos de ángulo de alabeo, ángulo de cabeceo o altitud. La frecuencia de interacción del agente se puede establecer en un valor inferior al del paso temporal del simulador para permitir entradas de control más realistas. El entorno también proporciona una función de recompensa que incentiva al agente a reducir la distancia al siguiente punto de paso y a alcanzarlo mediante una recompensa adicional, al tiempo que penaliza entradas de control excesivas o errores de rumbo y cabeceo elevados, así como la proximidad a las condiciones de fallo.
De nuevo, los tipos se definen utilizando pydantic para facilitar su validación y acceso y se encuentran en envs/env_types.py. La clase Navigation define información útil para la navegación, como el punto de paso actual, la distancia al punto de paso, el error de rumbo, si se ha alcanzado el punto de paso y otros parámetros relevantes. La clase RewardInfo reúne la información de estado, acción y navegación en una misma estructura, que se utiliza como entrada para calcular la recompensa y guardar registros durante el entrenamiento para análisis posteriores o intermedios. La clase FailConditions define los límites inferiores y superiores de las condiciones de fallo, como los ángulos máximos de alabeo y cabeceo, los límites de altitud y otros parámetros relevantes. El entorno utilizará estos límites para determinar si el episodio debe terminar debido a una condición de fallo.
La clase del entorno WaypointNavigationEnv implementa los métodos estándar de Gym, como reset y step. El método reset borra los estados del simulador y sitúa la aeronave en el estado inicial. Durante el entrenamiento, los puntos de paso se generan aleatoriamente con una separación y un número determinados, definidos en la clase WaypointConfig. En cada estado se genera un cambio de rumbo aleatorio dentro del cambio máximo de rumbo definido y después se genera cada punto de paso a una distancia aleatoria dentro de la separación definida, en la dirección del nuevo rumbo. La altitud de cada punto de paso también se genera aleatoriamente dentro del rango de altitud definido. Para obtener las coordenadas globales x e y del punto de paso en cada paso, se actualizan los versores de cada sistema de coordenadas de los puntos de paso utilizando el rumbo actual, de modo que las coordenadas relativas de los puntos de paso se puedan proyectar sobre el sistema de coordenadas global. Las ecuaciones utilizadas para generar los puntos de paso son las siguientes:
En modo de evaluación, los puntos de paso se pueden establecer manualmente para realizar pruebas consistentes. El método reset llama a un método para generar los puntos de paso si está en modo de entrenamiento o utiliza los puntos de paso establecidos previamente si está en modo de evaluación. Por su parte, el método step recibe una acción del agente, la aplica al simulador, calcula la recompensa, comprueba las condiciones de fallo y devuelve la observación, la recompensa, el indicador de finalización e información adicional.
Espacio de observaciones
El vector de observaciones puede incluir variables dimensionales o estar normalizado entre -1 y 1 en función de la configuración. Durante el entrenamiento, se observó un mejor comportamiento de aprendizaje al utilizar observaciones y acciones normalizadas. El vector de observaciones incluye variables de estado como las velocidades en ejes cuerpo, los ángulos de Euler y las velocidades angulares, así como la diferencia en cada coordenada respecto al siguiente punto de paso y algunas métricas de error, como la distancia al punto de paso, la distancia horizontal al punto de paso, la diferencia de altitud respecto al punto de paso, el error de rumbo y el error de cabeceo. El vector completo de observaciones es el siguiente:
donde son las velocidades y velocidades angulares normalizadas en ejes cuerpo dadas por , son las diferencias en cada coordenada respecto al siguiente punto de paso, es la distancia al punto de paso, es la distancia horizontal al punto de paso, es la diferencia de altitud respecto al punto de paso, es el error de rumbo y es el error de cabeceo. El error de cabeceo se calcula a partir de la diferencia de altitud y la distancia horizontal respecto al punto de paso, en un rango entre y , y después se normaliza entre -1 y 1. Por otro lado, el error de rumbo se calcula como la diferencia entre el rumbo actual y el rumbo deseado hacia el punto de paso, ajustada entre y y después normalizada entre -1 y 1.
El error de rumbo deseado se calcula de manera diferente según se trate o no del último punto de paso. Si es el último, el rumbo deseado se calcula como el ángulo entre la posición actual y el último punto de paso. Si no es el último, el rumbo deseado se calcula como una media ponderada entre el rumbo al siguiente punto de paso y el rumbo al punto de paso posterior. Este último se calcula como el ángulo de la recta que pasa por ambos puntos de paso. De esta forma, se proporciona al agente cierta información sobre el siguiente rumbo requerido para evitar giros bruscos al alcanzar un punto de paso. El rumbo deseado se calcula de la siguiente manera:
Condiciones de finalización
El episodio termina cuando la aeronave alcanza el último punto de paso o cuando se cumple una condición de fallo. Como se ha mencionado antes, las condiciones de fallo se definen en la clase FailConditions e incluyen el ángulo máximo de alabeo, el ángulo máximo de cabeceo, la altitud mínima y máxima y la distancia máxima al siguiente punto de paso. Si se cumple alguna de estas condiciones, el episodio termina y el agente recibe una recompensa negativa. Los ángulos máximos de alabeo y cabeceo se definen para evitar maniobras excesivas que puedan provocar una entrada en pérdida o una pérdida de control. La distancia máxima al siguiente punto de paso se define para evitar que la aeronave se aleje demasiado de los puntos de paso y, en ese caso, finalizar el episodio de forma anticipada para no desperdiciar pasos de tiempo.
Como la aeronave no siempre alcanzará el último punto de paso, también se implementa una condición de puntos de paso sobrepasados. Esta condición comprueba si la aeronave ha sobrepasado el siguiente punto de paso calculando el producto escalar entre el vector que va de la aeronave al punto de paso y el vector que va del punto de paso al siguiente punto de paso, . Si el producto escalar es negativo, significa que la aeronave ha sobrepasado el punto de paso y el entorno cambia al siguiente. De este modo, si la aeronave sobrepasa un punto de paso, puede continuar hacia el siguiente sin tener que volver atrás, evitando un comportamiento típico de oscilación alrededor del punto de paso.
Función de recompensa
La función de recompensa está diseñada para incentivar al agente a seguir los puntos de paso cada vez más de cerca, al tiempo que penaliza entradas de control excesivas y errores elevados de rumbo, cabeceo y alabeo para evitar maniobras agresivas. La primera función de recompensa utilizada se basaba en la distancia, de acuerdo con la utilizada en el artículo [3], donde se define una función de recompensa exponencial basada en la distancia. La expresión es la siguiente:
donde es la distancia absoluta en metros al siguiente punto de paso y es un factor de escala. Cuanto más cerca está la aeronave del punto de paso, mayor es la recompensa, con una recompensa máxima de 0 cuando la aeronave se encuentra exactamente en el punto de paso.
Sin embargo, la aeronave no alcanzará exactamente el punto de paso para evitar oscilaciones a su alrededor, por lo que se otorga una recompensa adicional cuando la aeronave se encuentra dentro de un determinado radio definido en la clase WaypointConfig. Esto se considera como haber alcanzado el punto de paso y se cambia al siguiente. Como alternativa, si la aeronave sobrepasa el punto de paso, también se cambia al siguiente, pero sin recibir la recompensa adicional. Esto incentiva al agente a alcanzar el punto de paso sin sobrepasarlo y evita oscilaciones a su alrededor.
Aunque esta función de recompensa puede funcionar en algunos casos, se comprobó que el agente aprende más rápido utilizando una recompensa que penaliza o incentiva directamente la mejora de la distancia al punto de paso con respecto a la distancia del paso anterior. Se probaron muchas variantes, desde una suma ponderada de un término de progreso y penalizaciones por acciones, error de rumbo y error de cabeceo, pero la que mejor funcionó fue la siguiente:
donde la primera parte es el término de progreso, es la distancia normalizada al punto de paso en el paso anterior, es la distancia actual normalizada al punto de paso y es un factor de escala para el término de progreso. Ambas distancias normalizadas escalan xy por 1000 m y z por 100 m para tener un rango similar. Además, se aplica un factor de distancia para aumentar la recompensa cuando la aeronave está más cerca del punto de paso. Este factor aumenta linealmente de 1 a 6 cuando la aeronave se encuentra dentro de una distancia umbral determinada al punto de paso, hasta alcanzar el radio del punto de paso .
La segunda parte consiste en términos de penalización exponencial para el error de rumbo, el error de cabeceo, el ángulo de alabeo y las deflexiones de las superficies de control. Aquí es el error de rumbo, es el error de cabeceo, es el ángulo de alabeo, es un umbral de ángulo de alabeo por debajo del cual no se aplica penalización, son las deflexiones de las superficies de control correspondientes a alerones, timón de profundidad y timón de dirección, respectivamente, y son factores de escala para cada término de penalización. El uso del término de progreso incentiva al agente a acercarse al punto de paso en cada paso, mientras que los términos de penalización desincentivan las entradas de control excesivas y los errores elevados de rumbo, cabeceo y alabeo. La penalización por ángulo de alabeo solo se aplica cuando el ángulo de alabeo supera un determinado umbral, para permitir las maniobras de alabeo necesarias durante los giros sin recibir penalizaciones. Los factores de escala se pueden ajustar para equilibrar la importancia de cada término de la función de recompensa.
Además, se otorga una recompensa adicional cuando la aeronave alcanza un punto de paso y una recompensa negativa cuando el avión sobrepasa un punto de paso sin alcanzarlo o cuando se cumple una condición de fallo. La recompensa adicional por alcanzar un punto de paso incentiva al agente a alcanzar los puntos de paso, mientras que se define otra recompensa negativa para evitar ángulos de alabeo elevados cercanos al límite del ángulo de alabeo. Esta recompensa negativa anticipa la condición de fallo e incentiva al agente a evitar ángulos de alabeo elevados. La expresión de estas recompensas es la siguiente:
donde es un umbral intermedio de ángulo de alabeo inferior al límite máximo de ángulo de alabeo definido en la clase FailConditions. La recompensa adicional por alcanzar un punto de paso se establece en +20, mientras que la recompensa negativa por sobrepasar un punto de paso sin alcanzarlo se establece en -10. Si la aeronave alcanza todos los puntos de paso, se otorga una recompensa adicional de +50. La recompensa negativa por condiciones de fallo se establece en -20. Estos valores se pueden ajustar para equilibrar la importancia de cada término de recompensa en la función de recompensa global.
La función de recompensa se implementa en el módulo envs/rewards.py y se llama desde el método step del entorno. La función de recompensa recibe como entrada el estado actual, la acción y la información de navegación y devuelve la recompensa calculada. La función de recompensa se puede modificar o sustituir fácilmente para experimentar con diferentes estrategias de recompensa.
Entrenamiento del agente de RL
El agente de RL se entrena utilizando la biblioteca Stable Baselines3 y el algoritmo PPO. El script de entrenamiento se encuentra en training/waypoint/train_waypoint_control.py. El script crea el entorno de navegación por puntos de paso, define el agente PPO con una política MLP personalizada y entrena al agente durante un número determinado de pasos de tiempo definido en el archivo training/configs/train_config.yaml.
Registros y visualización
El progreso del entrenamiento se registra utilizando WandB para facilitar la supervisión y el análisis de algunas métricas, como la pérdida del agente o la pérdida de valor, mientras que se implementa un sistema de registro personalizado para guardar información adicional para su análisis posterior y el modelo entrenado se guarda en un archivo para su uso posterior dentro del directorio models.
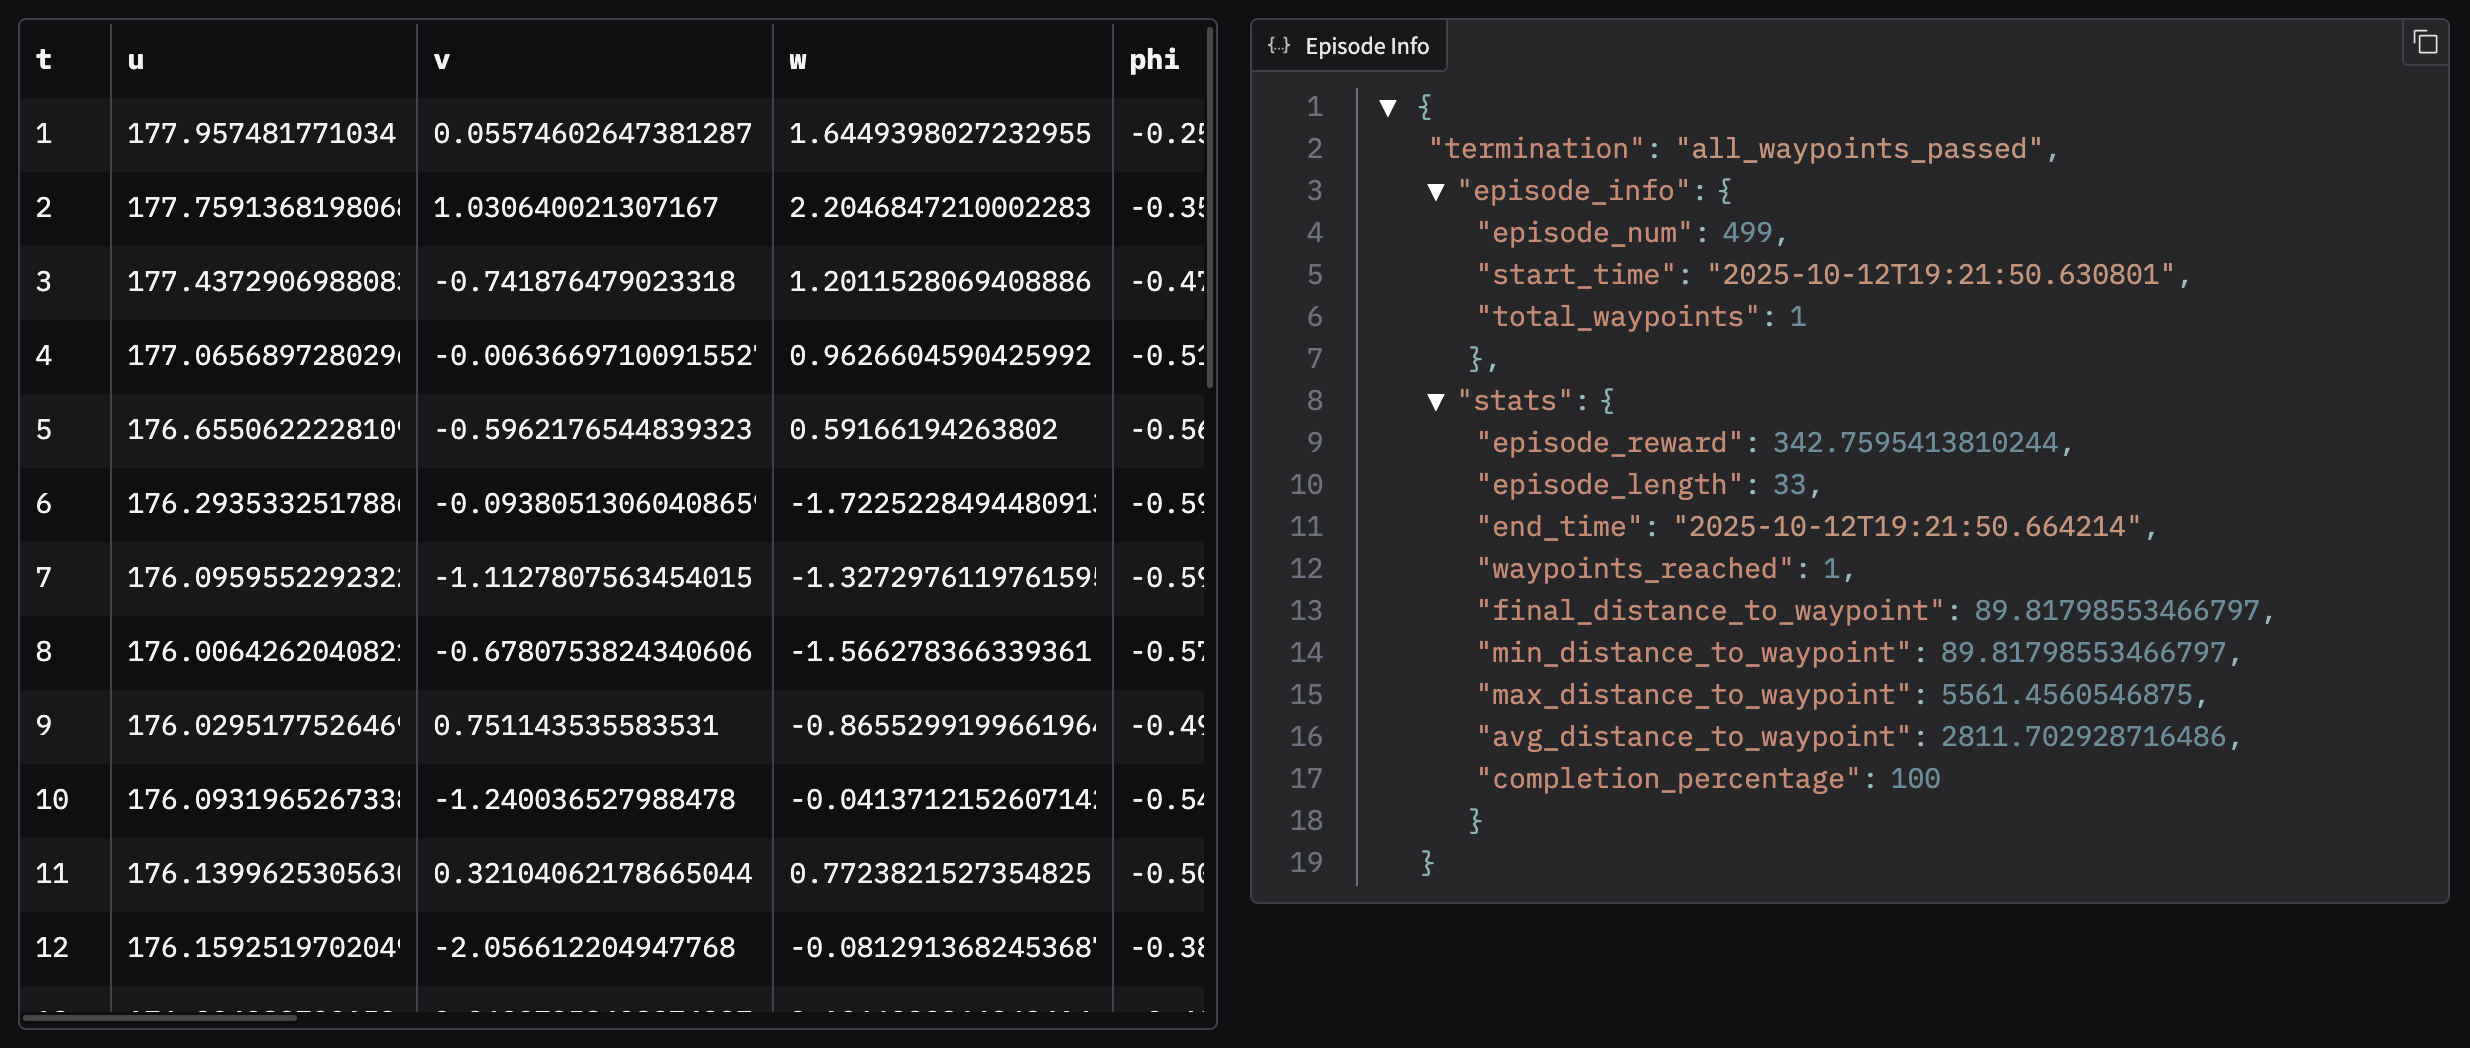
Durante el entrenamiento, el entorno guarda registros del estado, la acción y la información de navegación cada n episodios, según se define en el archivo de configuración del entrenamiento training/configs/train_config.yaml. Los registros se guardan como archivos pickle en el directorio training/waypoint/logs y se pueden utilizar para su análisis o visualización posteriores. Los registros incluyen información como el estado de la aeronave, la acción realizada, la información de navegación (como la distancia al punto de paso, el error de rumbo, el error de cabeceo, etc.) y la recompensa recibida, así como algunas estadísticas, como la duración del episodio, la recompensa total y el número de puntos de paso alcanzados. Los registros se pueden utilizar para analizar el rendimiento y el comportamiento del agente durante el entrenamiento o en una evaluación posterior.
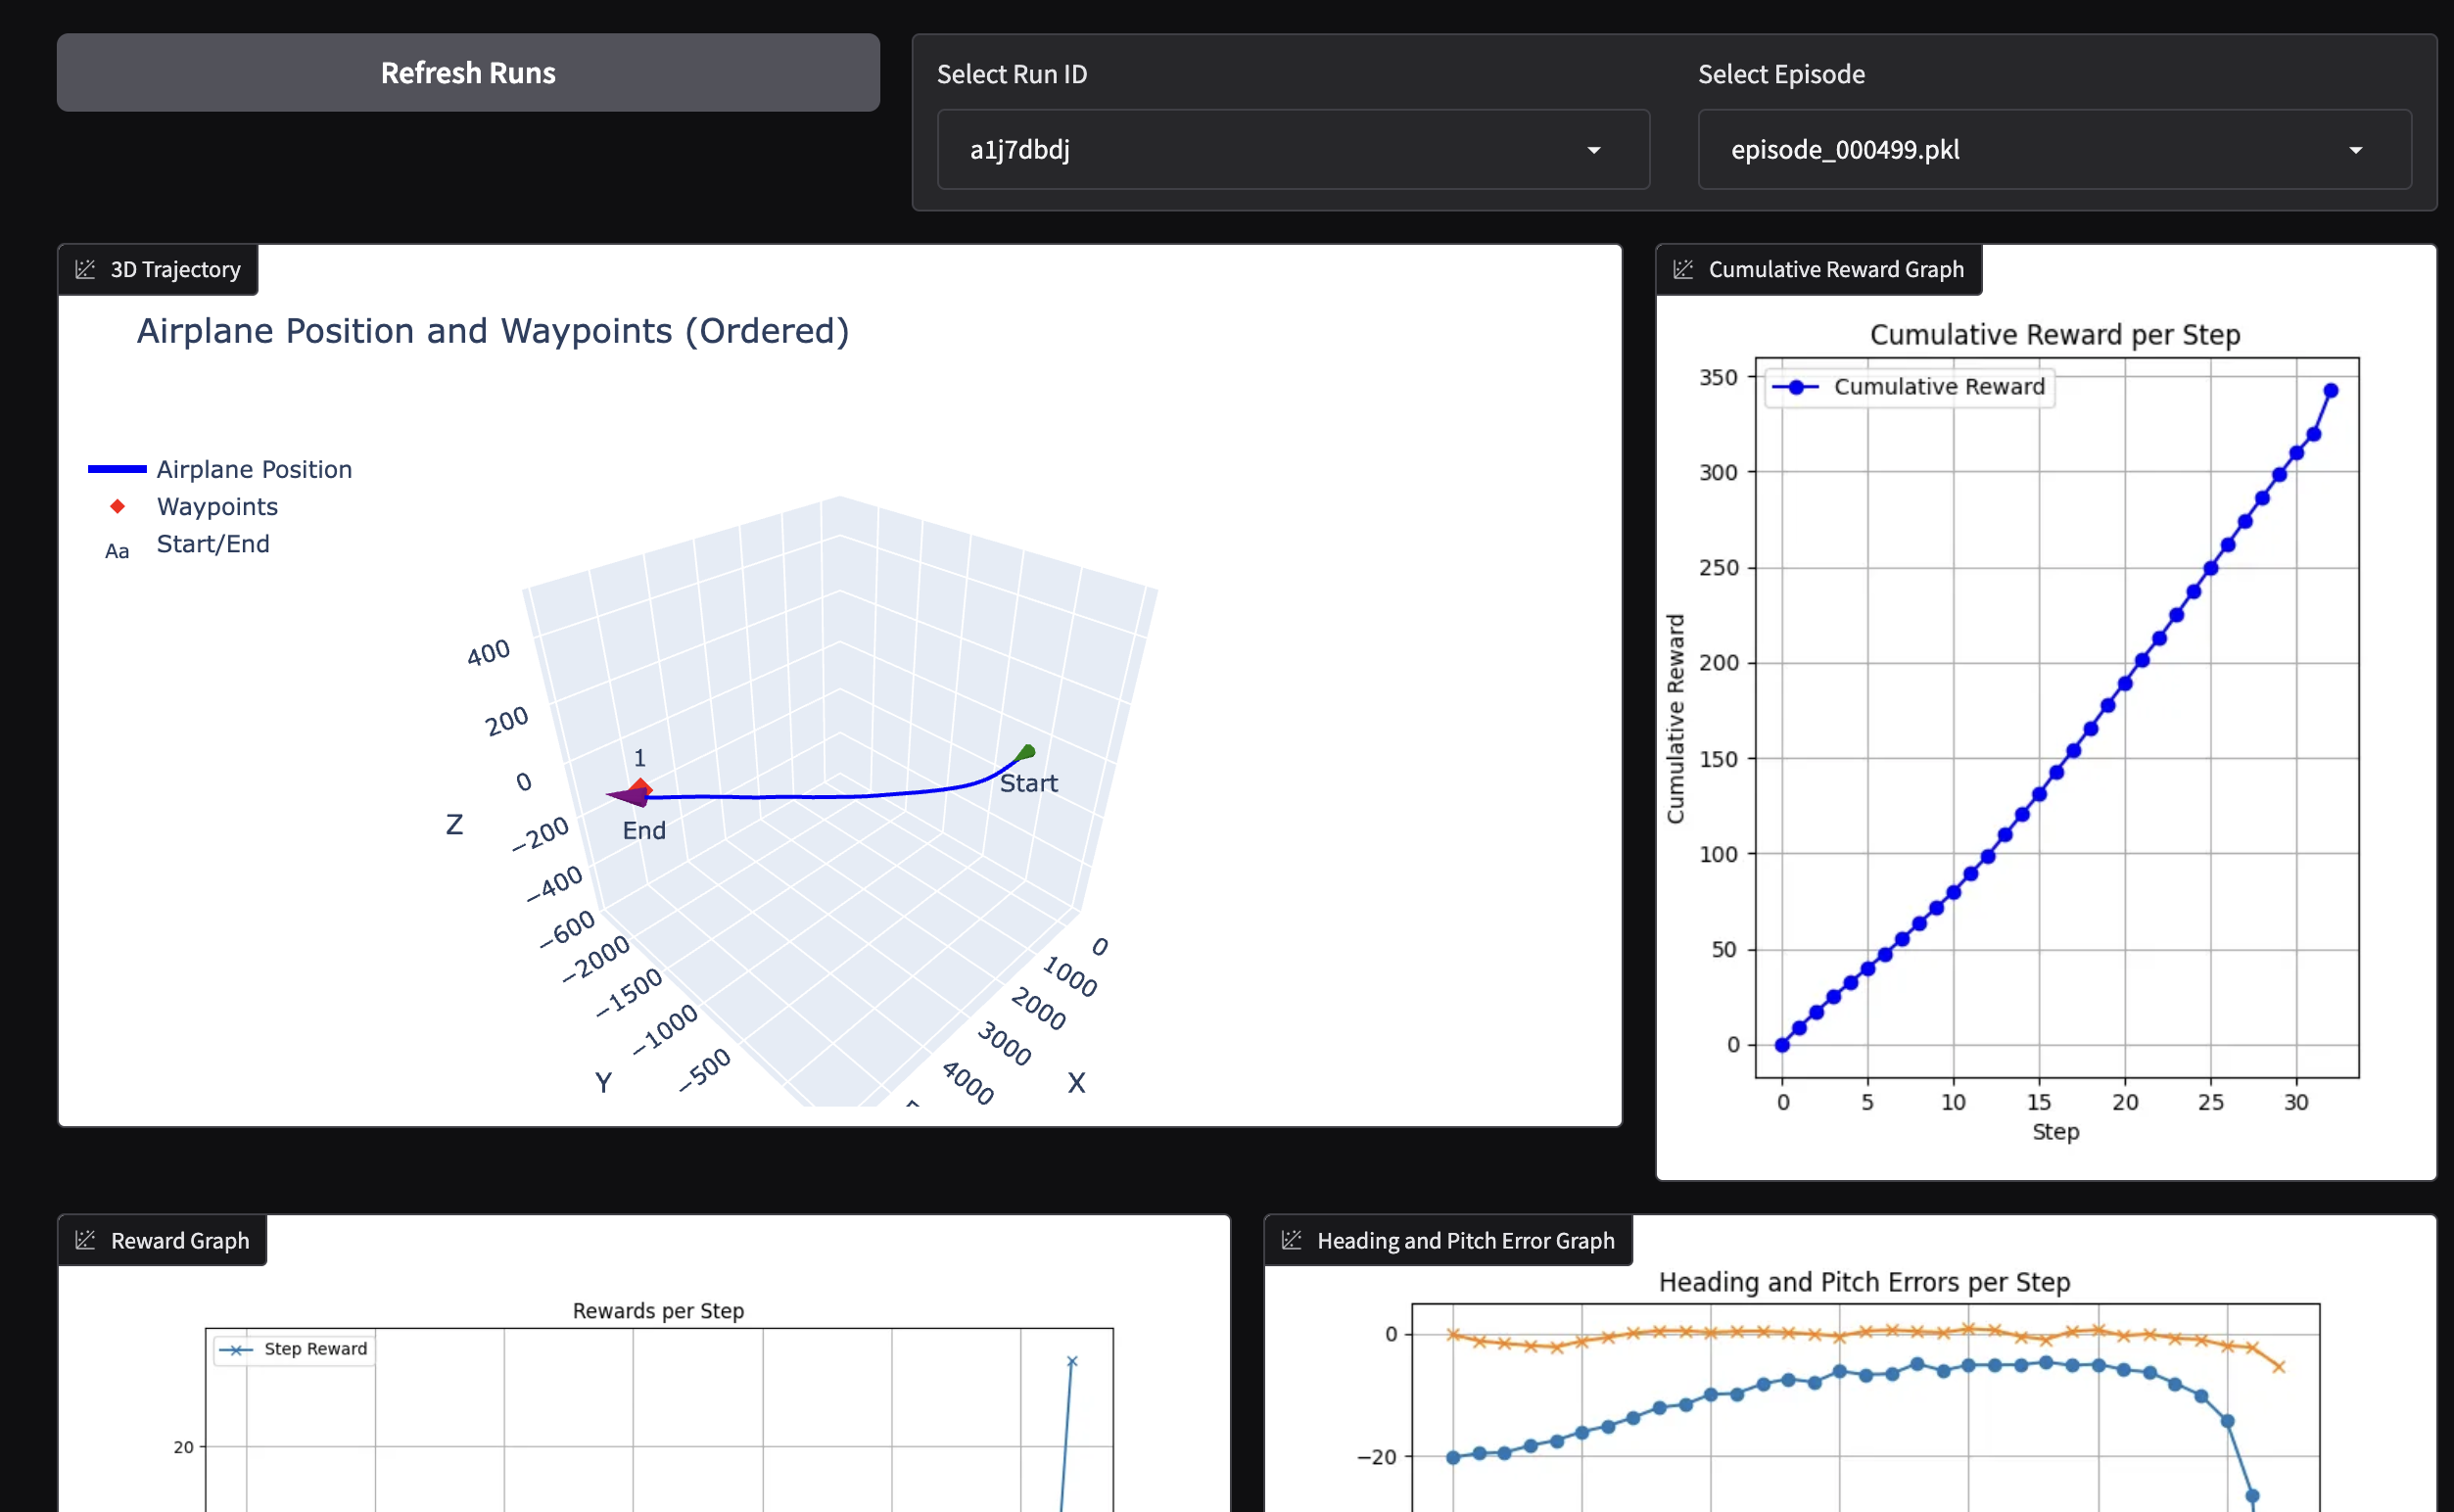
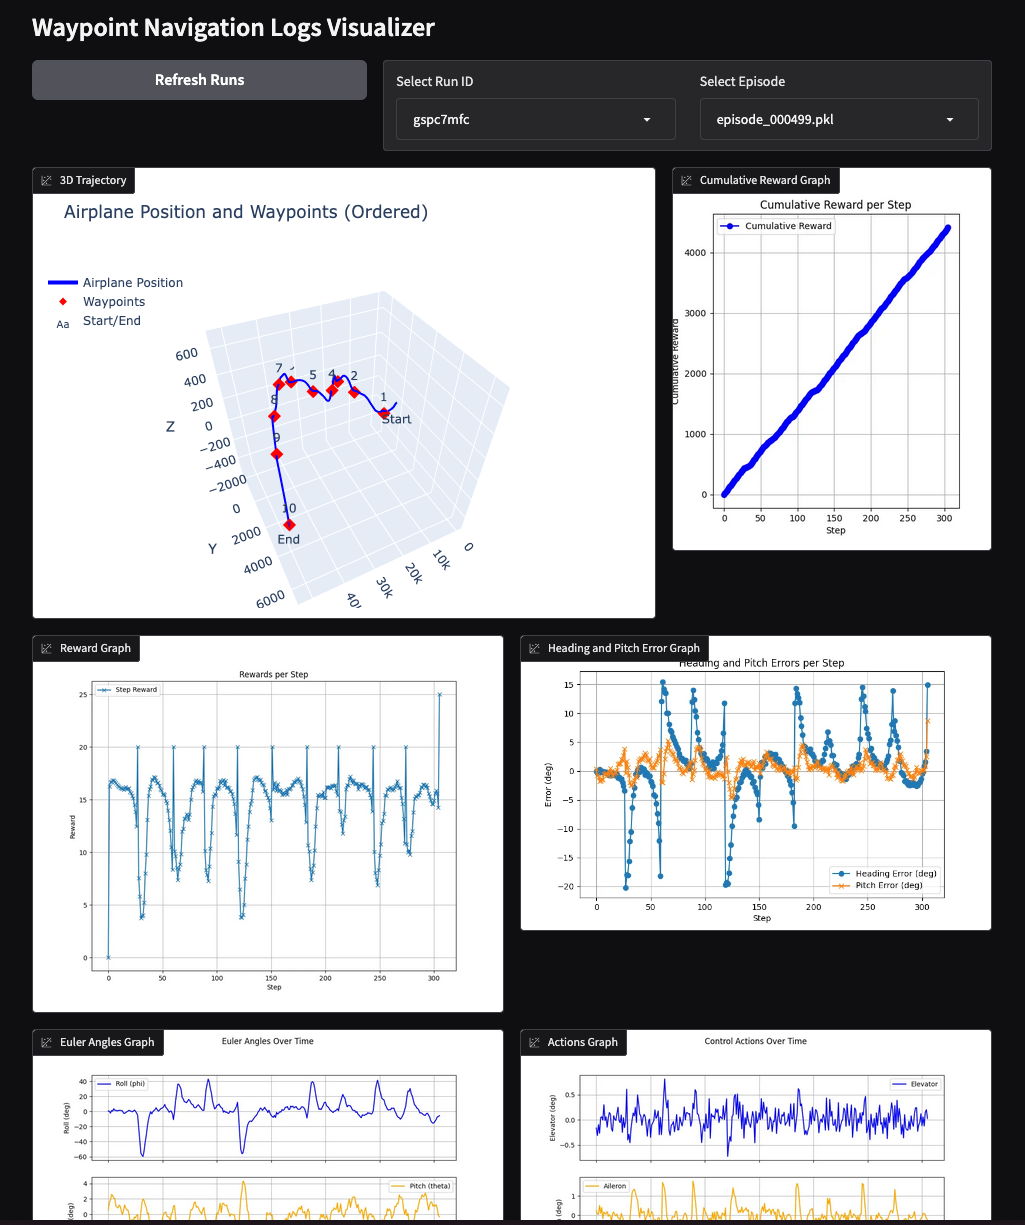
Para facilitar el análisis de los registros, se proporciona un script de visualización en training/waypoint/logs_visualizer.py. Este script utiliza la biblioteca Gradio para crear una interfaz web sencilla que permite cargar y visualizar los registros. El script representa la trayectoria 3D de la aeronave, los ángulos de Euler y las acciones a lo largo del tiempo, muestra los datos de estado en una tabla y otra información para su análisis. A continuación se muestra un ejemplo de la interfaz web:
Ajuste de hiperparámetros
El script de entrenamiento utiliza un conjunto de hiperparámetros definidos en el archivo training/configs/train_config.yaml. Estos hiperparámetros incluyen:
- Parámetros principales de entrenamiento de PPO que definen cómo recopila experiencia. Incluyen
n_steps, que define el número de pasos que se ejecutan para cada entorno por actualización,batch_size, que define el tamaño de los minilotes, yn_epochs, que define el número de épocas que se realizan por actualización. Estos parámetros son importantes para la estabilidad del entrenamiento y la calidad de la política aprendida. - Parámetros de descuento y estimación de la ventaja que definen cómo se descuentan las recompensas futuras y cómo se estima la ventaja. Incluyen
gamma, que es el factor de descuento de la recompensa esperada acumulada , ygae_lambda, que es el parámetro GAE (estimación generalizada de la ventaja). Estos parámetros son importantes para el equilibrio entre sesgo y varianza en la estimación de la función de valor. - Coeficientes de la función de pérdida, como
ent_coef, que es el coeficiente de entropía que penaliza una política de baja entropía (determinista), ovf_coef, que es el coeficiente de la función de valor. Esto determina la importancia relativa de la pérdida de la función de valor con respecto a la pérdida de la política. - Parámetros de arquitectura de la política, como
net_arch, que define la arquitectura de la red neuronal utilizada para la política y la función de valor. Incluyen el número de capas y el número de neuronas por capa. La arquitectura de la red neuronal es importante para la capacidad del modelo de aprender políticas complejas. Además, se puede definir la función de activación mediante el parámetroactivation_fn. Como una inicialización adecuada de los pesos es importante para la convergencia del entrenamiento, se puede establecer el parámetroortho_initpara utilizar una inicialización ortogonal de los pesos de la red neuronal ylog_std_initpara definir el logaritmo inicial de la desviación estándar de la distribución gaussiana de la política, donde un valor menor produce una menor exploración inicial. - La exploración dependiente del estado se puede activar mediante el parámetro
sde. Esto permite al agente explorar más en los estados en los que tiene menos certeza sobre la función de valor. El parámetrosde_sample_freqdefine con qué frecuencia se muestrea una nueva matriz de ruido para la exploración.
Para encontrar los mejores hiperparámetros para el entrenamiento, se proporciona un script de ajuste de hiperparámetros en training/waypoint/hyperparameter_search.py. Este script utiliza la biblioteca Optuna para realizar una búsqueda de hiperparámetros utilizando un espacio de búsqueda definido. El espacio de búsqueda incluye los principales hiperparámetros mencionados anteriormente y se puede ajustar para incluir o excluir determinados parámetros. El script ejecuta múltiples pruebas con diferentes combinaciones de hiperparámetros y evalúa el rendimiento del agente utilizando una métrica definida, como la recompensa media a lo largo de un determinado número de episodios. Los resultados se guardan en hyperparameter_search/results, incluidos los mejores hiperparámetros encontrados durante la búsqueda.
Entrenamiento y pruebas
Para entrenar al agente de RL, tras configurar los hiperparámetros del agente y otros parámetros de entrenamiento, como los pasos de tiempo totales, la frecuencia de evaluación, la frecuencia de registro y las rutas de guardado
en el archivo training/configs/train_config.yaml, el siguiente paso es ejecutar el archivo training/waypoint/train_waypoint_control.py, que carga el archivo de configuración, crea el entorno y el agente PPO e inicia el proceso de entrenamiento. El entrenamiento se puede ejecutar mediante el siguiente comando:
python training/waypoint/train_waypoint_control.pyEl proceso de entrenamiento se dividió en etapas. Primero, se entrenó al agente para alcanzar un único punto de paso, estableciendo el número mínimo y máximo de puntos de paso en 1 en el archivo training/configs/train_config.yaml. Esto permite al agente aprender el control básico de la aeronave y cómo alcanzar un punto de paso. Las siguientes gráficas muestran la pérdida de entrenamiento y la pérdida de valor durante el entrenamiento con un único punto de paso. Como resultado del progreso definido en la función de recompensa, la pérdida de entrenamiento disminuye en pocos episodios y el agente es capaz de alcanzar el punto de paso de forma consistente tras aproximadamente 100.000 pasos de tiempo.
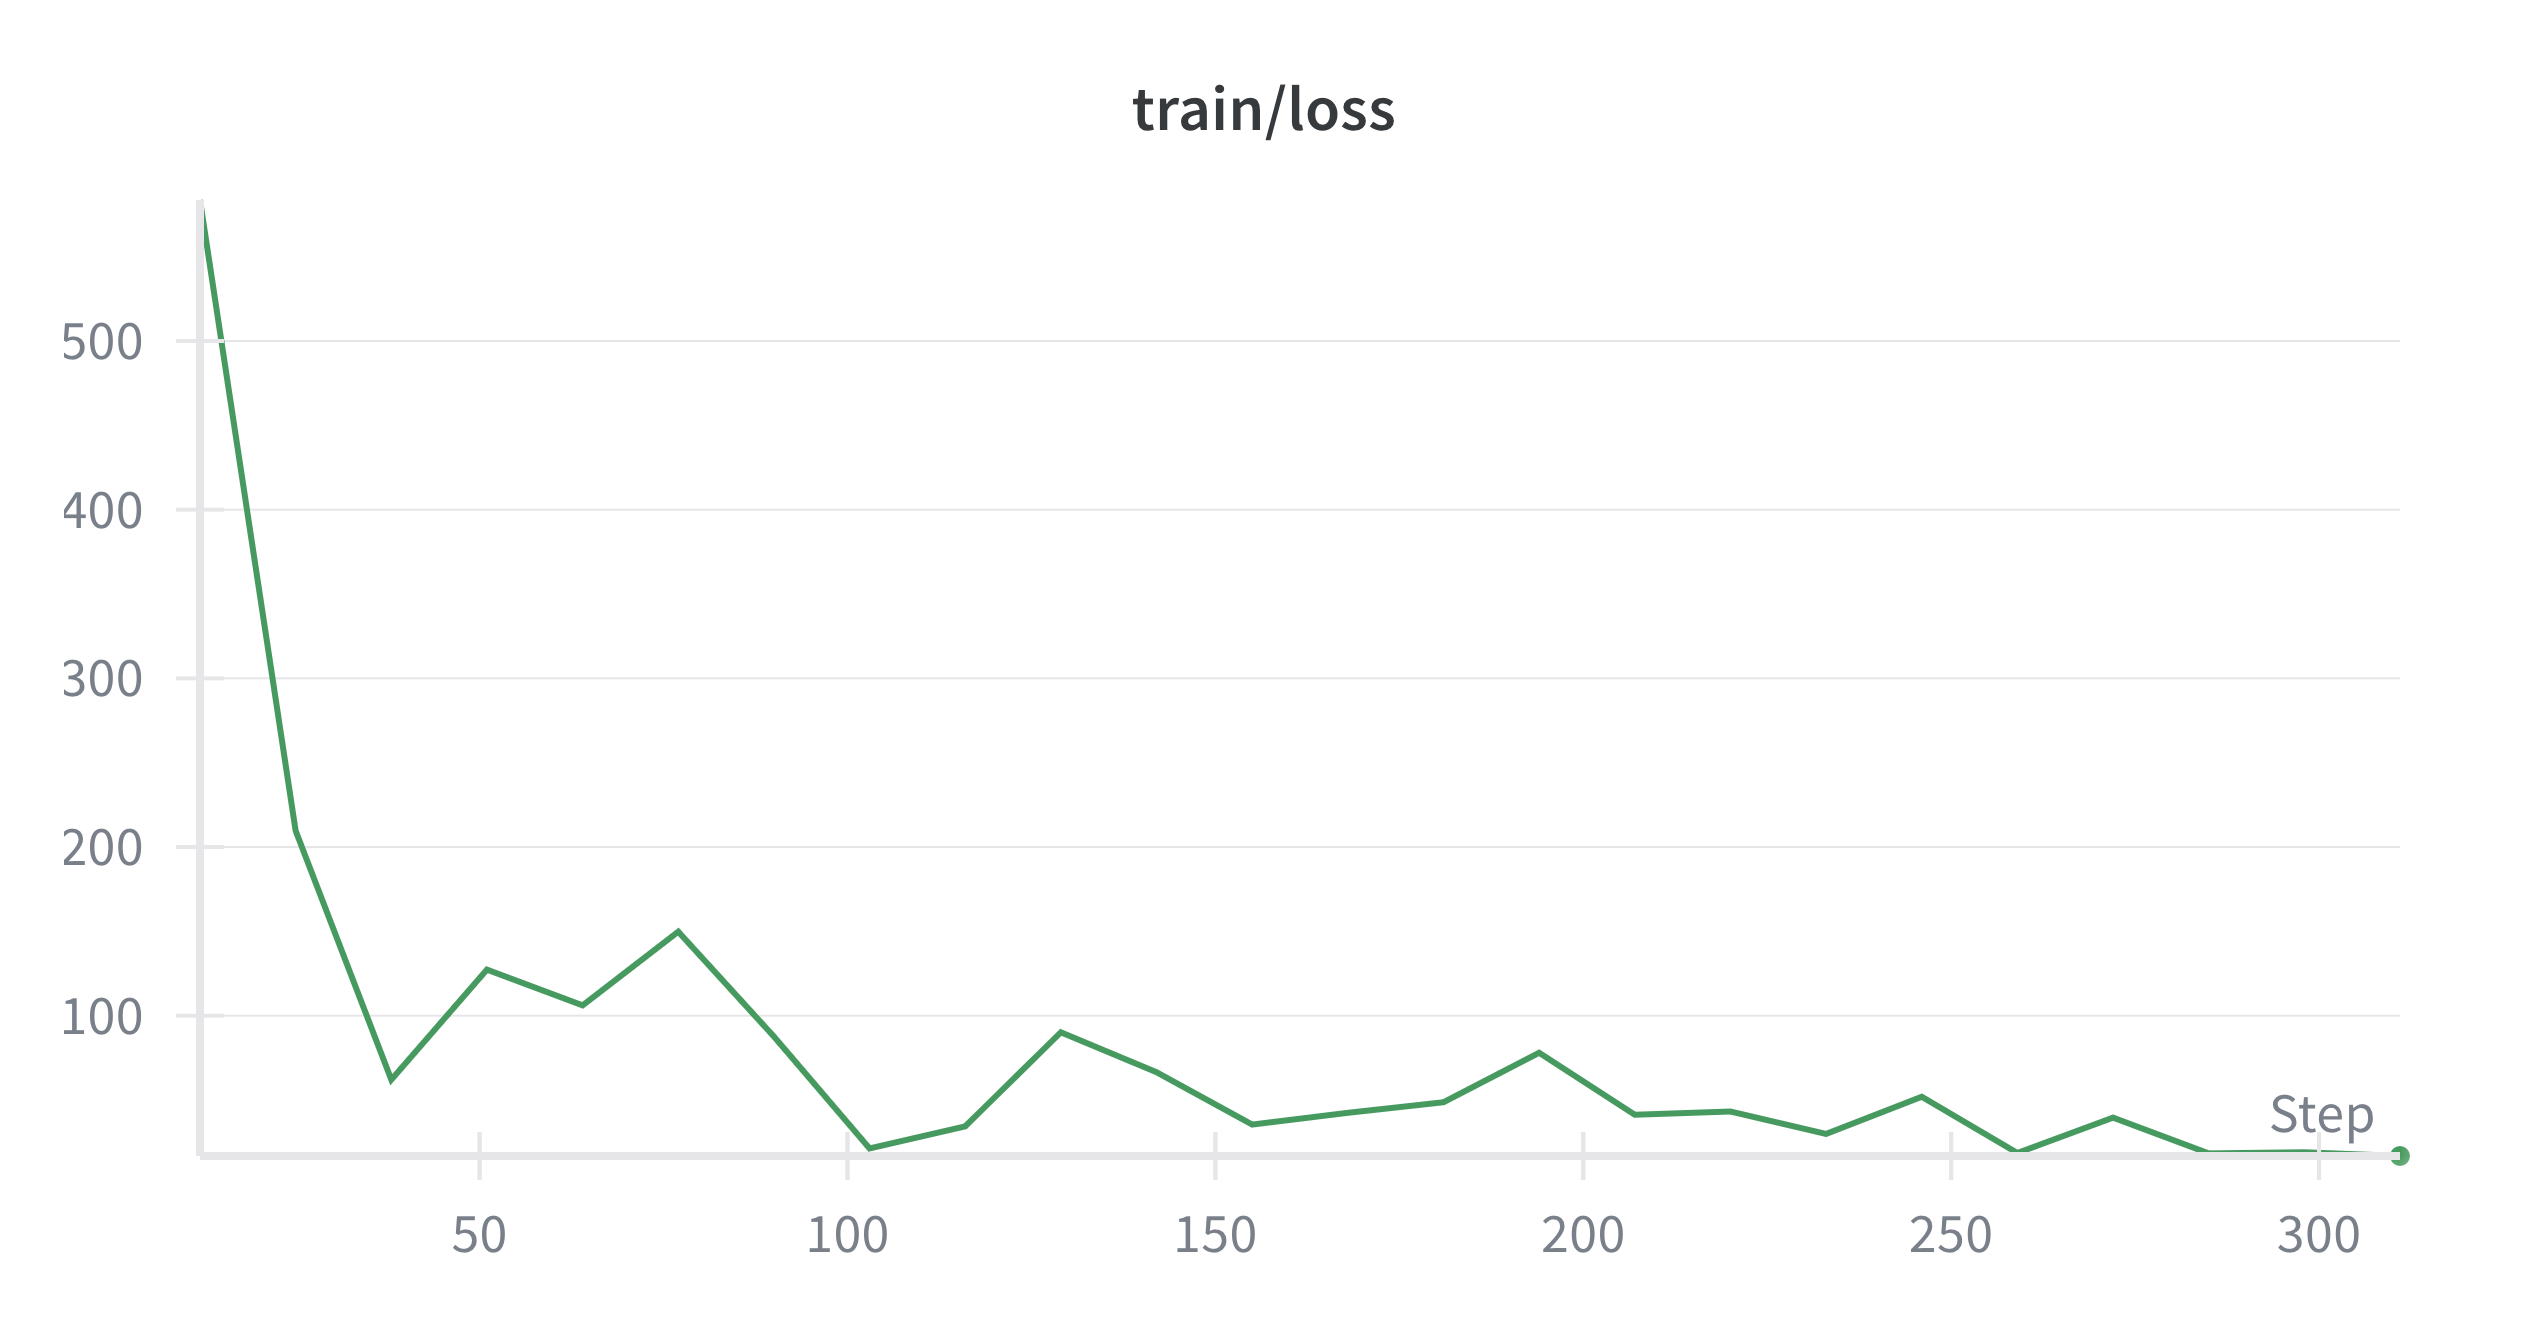
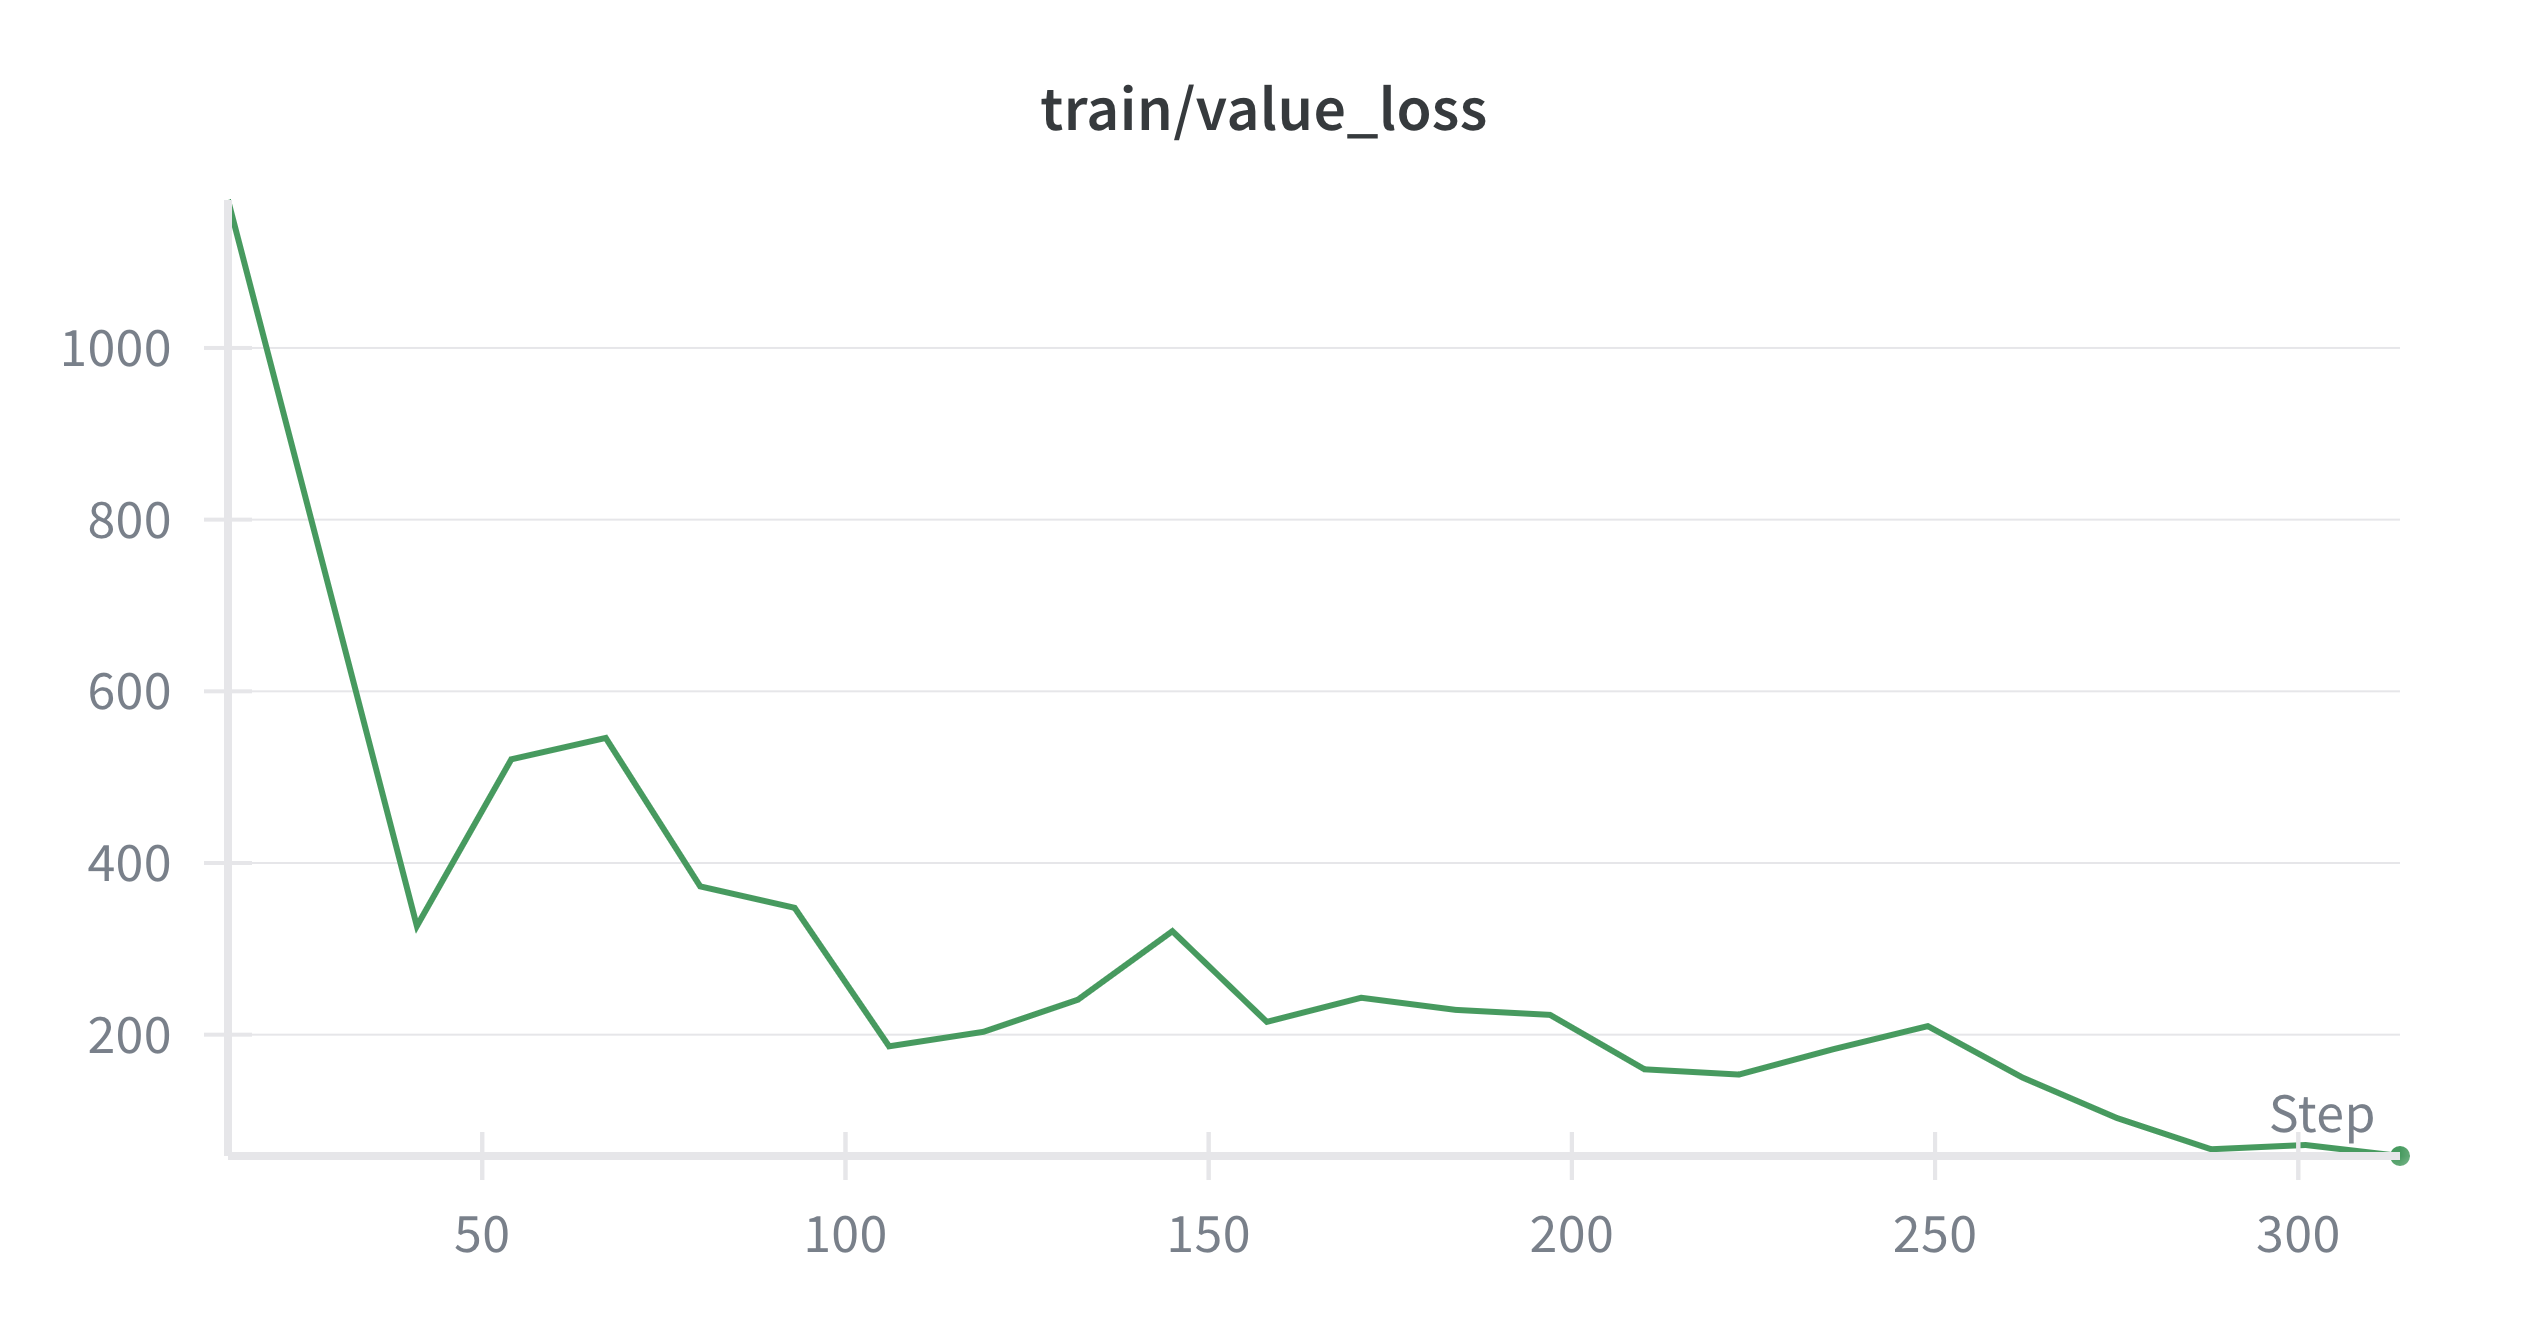
Una vez que el agente fue capaz de alcanzar un único punto de paso de forma consistente, el entrenamiento continuó con varios puntos de paso, estableciendo el número mínimo y máximo de puntos de paso en un valor superior. Esto permite al agente aprender a navegar por varios puntos de paso y a gestionar los giros y los cambios de altitud. El entrenamiento con solo 2 puntos de paso también es rápido y el agente es capaz de alcanzar ambos de forma consistente tras aproximadamente 500.000 pasos de tiempo. Para un número mayor de puntos de paso, se detectó un problema por el que el agente alcanzaba el límite de alabeo en la transición de algunos puntos de paso. Como solución, se implementó una recompensa negativa mayor para los ángulos de alabeo elevados, con el fin de incentivar al agente a evitarlos. De esta forma, el agente pudo aprender a evitar ángulos de alabeo elevados y alcanzar todos los puntos de paso de forma consistente tras 1 millón de pasos de tiempo. Las siguientes gráficas muestran la trayectoria, la recompensa, los errores, los ángulos de Euler y las deflexiones de las superficies de control de un episodio con 10 puntos de paso tras entrenar durante 1 millón de pasos de tiempo:
Para probar visualmente el comportamiento del agente, se implementa otra API REST sencilla en tests/agent_api, que implementa los mismos endpoints que la API del simulador, pero, en lugar de recibir deflexiones de las superficies de control, primero ejecuta un episodio completo utilizando el agente entrenado y después devuelve el estado en cada paso. De esta forma, la aplicación web se puede utilizar para visualizar el comportamiento del agente del mismo modo que con el simulador. Para ejecutar la API del agente, utiliza el siguiente comando:
# Python API REST
cd tests
python agent_api.py

# In another terminal, run the web-app
cd simulator_webapp
npm run dev
En el siguiente vídeo se puede ver un ejemplo de la aplicación web que muestra el comportamiento del agente:
donde los puntos de paso se muestran como toros blancos y la aeronave los sigue mediante maniobras suaves de alabeo. Aunque se entrenó para seguir 10 puntos de paso, en este caso es capaz de seguir 15 con éxito. En el simulador web, la traslación de la aeronave está escalada para mejorar la visualización, como se puede ver en la pantalla de estado de la esquina superior izquierda.
Agradecimientos
- [1] Miguel A. Gómez Tierno, Manuel Pérez Cortés, César Puentes Márquez, “Mecánica del Vuelo”, 2nd Edition, 2012.
- [2] Erwin Kreyszig, “Advanced Engineering Mathematics”, 10th Edition, 2011.
- [3] Francisco Giral, Ignacio Gómez, Soledad Le Clainche, “Intercepting Unauthorized Aerial Robots in Controlled Airspace Using Reinforcement Learning”, 2025.
- [4] Francisco Giral, https://github.com/fgiral000/bicopter_RL_control/tree/main, 2023.
- [5] R3F-takes-flight, https://github.com/Domenicobrz/R3F-takes-flight, 2023.
- [6] Jan Roskam, “Airplane Flight Dynamics and Automatic Flight Controls”, 2001.